先分清是"慢"还是"卡",别一上来就换服务
很多人一遇到代理IP不给力,第一反应是服务商不行,退订换一家。换完发现还是那个味儿。问题往往不在对方身上,而是你这条链路上有某个环节被堵住了。
我习惯先把"卡"拆成三种表现,对症才有意义:
第一种,延迟高。请求发出去,半天不回话,但一旦回了,数据是完整的。典型的距离问题或者路由绕路。
第二种,速度慢。连得上、回得来,就是下得慢,几十KB/s晃悠。典型的带宽被跑满。
第三种,时通时断。一半请求成功一半超时,或者跑着跑着报连接被重置。多数是并发数超了,或者本地端口被耗尽。
花三分钟做个小体检,比拍脑袋换服务有用得多。开个终端,先对着代理入口敲一下:
# 看往返延迟和丢包
ping -c 20 代理入口IP

# 看中间经过了多少跳、在哪一跳开始掉速
tracert 代理入口IP        # Windows
traceroute 代理入口IP     # macOS / Linux

# 单独下一个文件,看单线程能跑多少
curl -x http://用户名:密码@代理入口:端口 -o test.bin -w "速度: %{speed_download} B/s\n" 测试文件地址三个数字出来,问题基本就定位了。延迟稳定但速度低 → 往带宽方向查;速度还行但延迟抖 → 往节点距离查;两者都正常但任务老是失败 → 往并发数查。下面按这三条路走一遍。
带宽占用:先算清你手里到底有多少水管
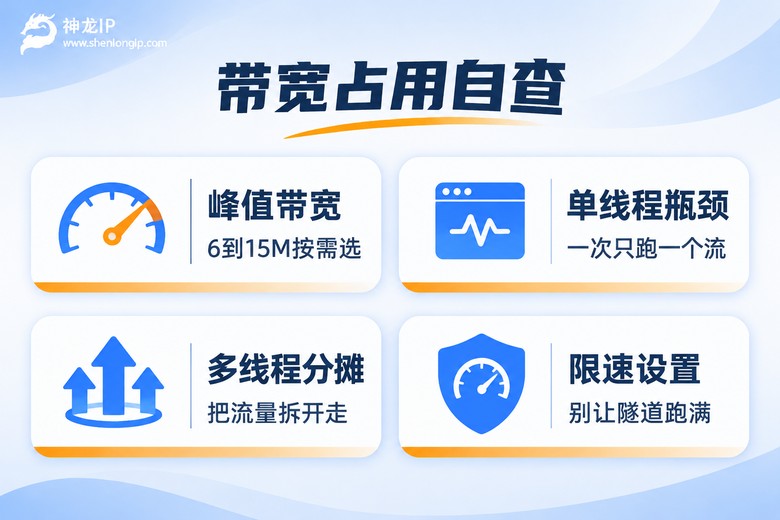
带宽这事最容易产生误会。服务商写"6M",指的是 6Mbps,换算成我们平时看到的下载速度要除以 8,也就是理论峰值 750KB/s。你要是拿习惯了的百兆宽带去对标,自然会觉得慢——但它本来就只值这么多。
| 标称带宽 | 理论下行峰值 | 跑1000个页面(约2MB/页)大概耗时 | 适合什么活 |
|---|---|---|---|
| 6Mbps | 约 750KB/s | 45 分钟左右 | 轻量采集、搜索结果校验 |
| 10Mbps | 约 1.25MB/s | 27 分钟左右 | 中等量级数据采集、多账号操作 |
| 15Mbps | 约 1.875MB/s | 18 分钟左右 | 图片视频类资源、压力测试 |
光看理论值没用,得看实际跑起来会不会被自己人堵死。常见的三个自我拥堵点:
一是单线程下载大文件。一条 TCP 连接吃不满整条隧道是常态,尤其跨城跨运营商的时候。这时候不是带宽不够,是没把带宽用起来。把大文件切成几段,用 3 到 5 条连接各下一段,速度往往能翻倍——但注意别开到 20 条,隧道会被自己的 ACK 包塞满,反而更慢。
二是图片和视频资源顺手一起拉。很多人写采集脚本时图省事,把页面里的图片、字体、统计脚本全下了。实际上你只要正文,那些东西占了七成流量。在请求头里限制资源类型,或者干脆只解析 HTML,速度立刻上一个台阶。
三是后台还有别的任务在跑。这个特别隐蔽。你以为当前只有一条任务,其实另一个脚本正在默默跑着定时任务,两边共用一个出口,谁也别想快。跑测速之前,先把其他进程停掉。
如果你反复确认过流量没超、脚本也没毛病,却总是顶到天花板,那大概率是产品选型的问题。市面上不少产品是不区分带宽的,一个池子里几百人共享出口,高峰期大家一起挤。神龙IP这边把带宽做成了可选项,6M 到 15M 按业务自己定,动态独享套餐给到 10Mbps 峰值,跑数据采集和 IP 轮换这类持续吃流量的场景会从容很多。自营机房的好处也在这儿——线路是自己的,高峰期的抖动会小一些。
节点距离:物理上离得远,怎么调都白搭
数据包不是瞬移的。从你的机器到目标服务器,中间每经过一台路由器都要花时间。国内跨省一个来回通常 20 到 60 毫秒,跨运营商可能再多 30 毫秒,要是绕了一圈国际出口,几百毫秒都算正常。这个底子是物理决定的,任何优化都只能在这个底子上做文章。
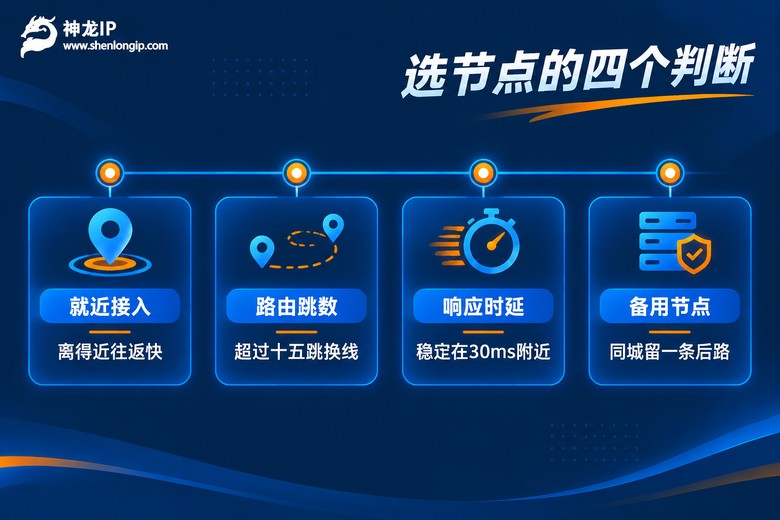
所以第一件事:别用离你最远的节点干活。北京的业务跑广州节点,本身就是给自己找不痛快。手上有一批任务要做,先看目标是哪个区域的,从对应城市里挑节点。神龙IP支持 200+ 城市精准定位,这个能力在很多场景下比带宽还重要——你要测某个城市的本地搜索结果,用当地节点跑出来的才是真实数据,从别的城市绕过去,结果根本不能作数。
第二件事:看路由跳数,不只看 ping 值。ping 低不代表路径好,有些线路延迟数字挺漂亮,但中间经过的跳数多、某一跳还老抖,实际跑起来一卡一卡的。traceroute 输出里如果有那么一两跳的延迟突然从 5ms 跳到 80ms,那就是绕路点了。遇到这种,换同城的另一个入口,往往立刻见效。
第三件事:给每个任务留一条后路。只配一个节点是有风险的。我的习惯是同一个城市至少准备两个入口,主节点连续三次超时就自动切到备用的。切换逻辑很简单,十行代码就够:
import time, requests

NODES = [
    "http://用户名:密码@节点A:端口",
    "http://用户名:密码@节点B:端口",
]

def fetch(url, retry=2):
    for i in range(retry):
        proxy = NODES[i % len(NODES)]
        try:
            r = requests.get(url, proxies={"http": proxy, "https": proxy}, timeout=8)
            if r.status_code == 200:
                return r.text
        except Exception:
            time.sleep(0.5)   # 别立刻重试,给链路一点缓冲
return None还有个容易被忽略的点:协议和加密也是有开销的。加密强度越高,握手越慢。如果你的任务对实时性要求高、本身传输内容又不敏感,选轻一点的协议通道会快一些。神龙IP支持 IKEv2、PPTP、L2TP、SSTP、SOCKS5 几种方式,数据全程加密,实际操作中 SOCKS5 在纯 HTTP 请求场景里通常延迟更低,适合高频短请求;需要稳定长连接的场景再换别的协议试试,别一个配置用到底。
并发数:跑得最快的那个设置,通常不是最大的那个
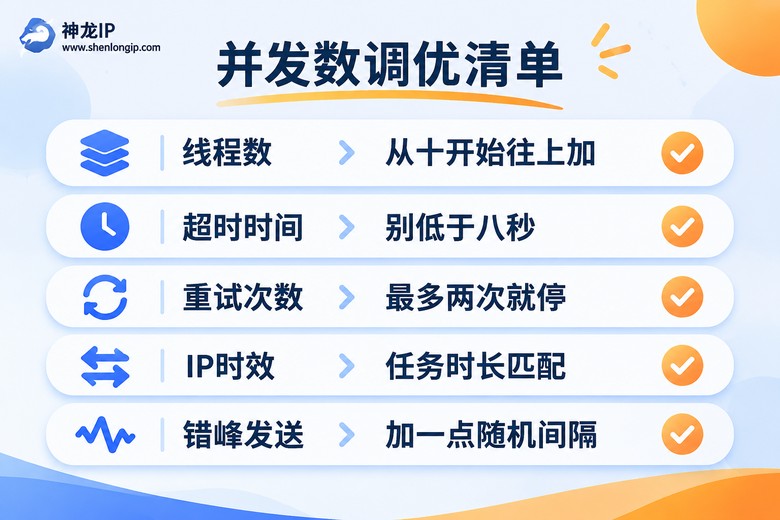
新手最爱把线程数拉到 200,觉得多就是快。结果呢,成功率掉到六成,整体耗时比 20 线程还长。原因很简单:每条连接都要占一个本地端口,都要做一次握手,都要在隧道里排队。超过带宽承载能力的并发,增加的只是排队时间和失败重试。
怎么找那个甜点值?别猜,测。从 10 线程开始,每轮加 10,记录三组数据:成功率、平均耗时、每秒完成数。你会发现每秒完成数会先涨后跌,那个拐点就是你这套配置的上限,一般是带宽的 2/3 处。找到之后,日常跑就压在这个数的 80% 上,留点余量给波动。
几个具体参数,我踩过坑总结出来的:
超时时间别设太短。很多人设 3 秒,跨城节点根本来不及回话就被判死刑了,然后疯狂重试,把隧道越撞越堵。8 到 10 秒是更稳的起点。
重试次数最多两次。两次都失败,说明是结构性问题,重试一百次也一样,不如换 IP 或者换节点。
IP 时效要和任务时长对齐。一个跑 40 分钟的任务,配了个 2 小时时效的 IP,中间被回收了就全白干。反过来,一个十几秒的短请求拿了个长期 IP,纯属浪费。神龙IP的动态高级和动态独享都支持 2 到 360 小时时效,按任务长度去配就行;如果是要长期挂着固定身份的活,静态高级那种长期固定 IP 更合适,运营商合作资源,走的是稳而不是快。
错峰发送。所有线程同一毫秒发请求,会造成瞬间拥塞。在每个任务开始前塞一个 50 到 300 毫秒的随机延迟,看着慢,整体吞吐反而更高。
from concurrent.futures import ThreadPoolExecutor
import random, time

def worker(task):
    time.sleep(random.uniform(0.05, 0.3))   # 错峰,别整齐划一
    return do_something(task)

with ThreadPoolExecutor(max_workers=20) as pool:   # 实测出来的甜点值
    results = list(pool.map(worker, task_list))
顺便提一句,Python 里 requests 用连接池要注意:默认的 urllib3 连接池对同一 host 只保 10 个连接,超过的会被丢弃重建。多线程高并发时把 pool_maxsize 调大,能省掉不少握手时间。
把三层叠起来看,问题往往出在最短的那块板
带宽、距离、并发,这三件事不是独立的。你把并发从 20 拉到 100,带宽瞬间就被打满,延迟跟着飙,你会误以为是节点太远。反过来,你换了个更近的节点,但带宽只有 6M,多线程一开照样卡。所以顺序很重要:
先定并发数(按带宽算出来,留 20% 余量)→ 再看带宽够不够(不够就换套餐,别硬扛)→ 最后优化节点和路由(同城多入口、避开绕路跳)。这个顺序反着来,你就得反复试错。
另外别忘了一个常被忽略的指标:30ms 以内的响应,用户在感知上就是"跟手"的。超过 150ms,人的体感就开始"卡"了,脚本的重试逻辑也会开始误判。所以优化目标不是"越快越好",而是把延迟稳在一个可控区间里——稳定比尖峰更值钱。
最后说句实在话,代理IP卡顿这个问题,六成靠参数调,四成靠选对产品。你把线程数、超时、时效都调好,带宽和节点这两项还是被产品卡着,那也是白费功夫。挑服务的时候,先看带宽能不能按需选、城市覆盖够不够细、是不是自己的机房,这三条比报价单上的数字重要得多。
常见问题
Q:同一个节点,白天跑得好好的,晚上就卡得不行,是带宽不够吗?
大概率是。晚高峰是全网拥堵时段,共享出口的产品受影响最明显。你可以做个小对比:同样 20 线程,白天和晚上各测一次每秒完成数,如果晚上只有白天的一半,那就是带宽被挤了。这种情况要么换成独享带宽的套餐,要么把跑量大的任务挪到白天或者凌晨。
Q:我把线程数从 20 加到 100,为什么总耗时反而变长了?
因为带宽是有上限的,超出的连接只能在隧道里排队,排队的连接还会触发超时重试,形成恶性循环。加并发只在"带宽还有富余"的时候有效。建议先测出无并发限制时的单线程速度,乘以带宽上限,再反推能撑多少个并发。
Q:IP 换得越勤,是不是越不容易卡?
不是。频繁获取新的 IP 意味着每次都要重新握手、重新走一遍路由,反而增加了延迟。换 IP 是为了解决"这个 IP 被目标拒绝了"的问题,不是为了提速。如果你的卡顿表现是延迟高、速度低,换 IP 基本没用,重点该放在带宽和节点上。
Q:怎么判断是代理的问题还是本地网络的问题?
关掉代理,直接用本地网络 ping 一下常用服务,看看延迟正常不正常。如果本地本身就抖,那代理再换也没用。再看 traceroute 的输出,如果卡在你自己宽带出口那一跳,那就是运营商的事;如果卡在后面的某一跳,才轮到代理节点背锅。