上周帮朋友盯一个商品价格监控脚本,前两百多个请求跑得顺顺当当,忽然整页整页返回验证码,日志里全是 429。他第一反应是代码出了 bug,翻了两小时逻辑没结果,最后发现原因特别朴素:同一个 IP 请求太密,被对方的风控规则盯上了。
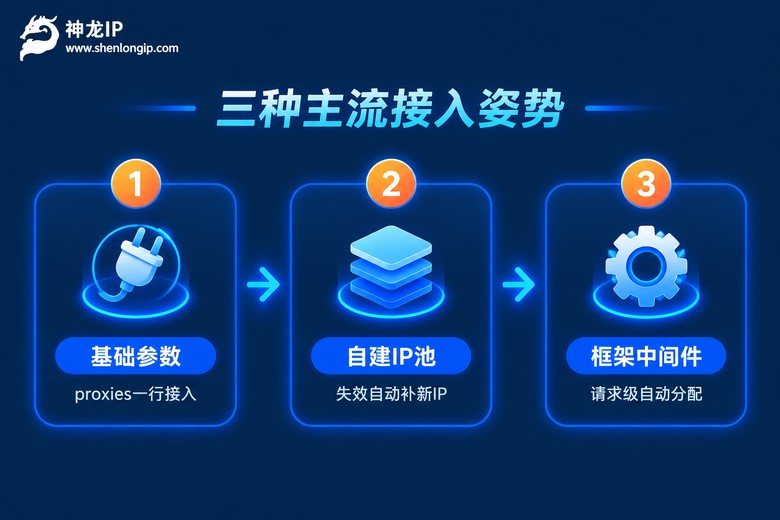
写爬虫的人几乎都撞过这堵墙,解法也不神秘——别让脚本老用同一个 IP 出门。这篇文章把 Python 里接入匿名代理的几种主流写法过一遍,从一行参数的基础用法,到自建 IP 池,再到框架级中间件,每种都配能直接跑的代码。
先弄清楚:匿名到底匿到什么程度
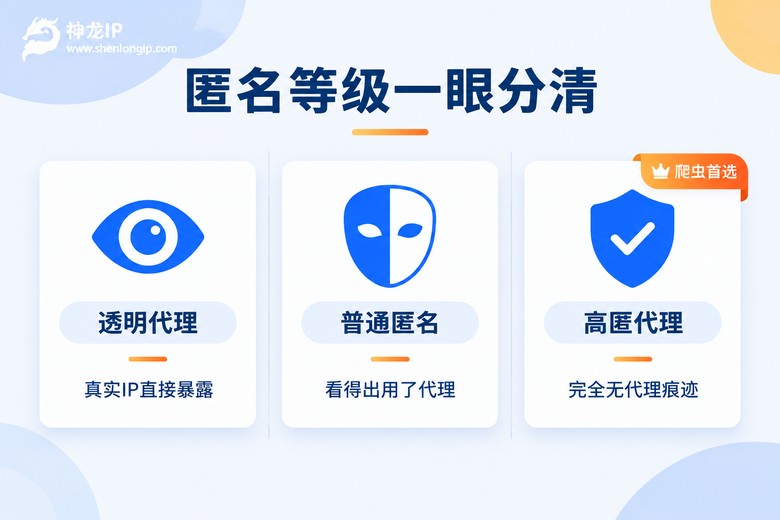
市面上代理服务都爱标"匿名"两个字,但匿名其实分三档,差别比想象中大。透明代理:请求能正常到达,但对方服务器从请求头里就能看到你的真实 IP,等于只借了个中转,什么都没藏。普通匿名:真实 IP 看不到了,但 Via、X-Forwarded-For 这类特征头还在,对方能判断出"这是个代理"。高匿代理:真实 IP 和代理特征全都抹掉,在对方眼里你就是一个普通访客。
| 等级 | 对方看到的IP | 代理特征头 | 适合场景 |
|---|---|---|---|
| 透明代理 | 你的真实IP | 有,且带真实IP | 基本只够调试用 |
| 普通匿名 | 代理IP | 有,能认出是代理 | 要求宽松的轻量任务 |
| 高匿代理 | 代理IP | 无 | 正经爬虫的首选 |
判断手里代理属于哪一档不用猜,请求一个回显服务,看它返回的请求头就知道了:
import requests

def check_anonymity(proxy):
    """传入形如 http://ip:端口 的代理,返回匿名度线索"""
    try:
        r = requests.get(
            "https://httpbin.org/get",
            proxies={"http": proxy, "https": proxy},
            timeout=8,
        )
        data = r.json()
        return {
            "对方看到的IP": data["origin"],
            "Via头": data["headers"].get("Via", "无"),
            "转发链": data["headers"].get("X-Forwarded-For", "无"),
        }
    except Exception as e:
        return {"错误": str(e)}

print(check_anonymity("http://123.45.67.89:8080"))
跑一下,如果"转发链"里出现了你本机的公网 IP,那就是透明代理,趁早淘汰。爬虫场景建议直接锁定高匿,后面所有写法都默认你手里是高匿资源。
姿势一:proxies 参数,最短路径接入
最直接的用法,requests 原生支持。从服务商后台拿到接入地址、端口、用户名和密码,拼进 proxies 字典就行:
import requests

proxies = {
    "http": "http://用户名:密码@代理地址:端口",
    "https": "http://用户名:密码@代理地址:端口",
}

resp = requests.get("https://httpbin.org/ip", proxies=proxies, timeout=10)
print(resp.json())   # {"origin": "代理IP"},说明生效了
如果拿到的是 SOCKS5 协议的接入点,换一下前缀,先装个依赖:
# pip install requests[socks]
proxies = {
    "http": "socks5h://用户名:密码@代理地址:端口",
    "https": "socks5h://用户名:密码@代理地址:端口",
}
这条最短的路径上有三个坑,都是我亲眼见人踩过的。一是 timeout 必须设,代理节点偶尔会抽风,不设超时的请求会一直挂着,把整个任务队列堵死。二是 https 这个 key 别漏,很多人只写 http 一行,结果页面里的 https 请求悄悄走了直连,自己还以为全程在用代理。三是 socks5h 和 socks5 的区别,前者让代理服务器去做域名解析,本地网络环境复杂时明显更稳。
姿势二:自建 IP 池,让脚本自己换
单个代理总有失效的时候,正经跑任务得备一个池子:谁挂了就剔除谁,再从剩下的里挑。一个最小可用的轮换器,四十行以内能写完:
import random
import time
import requests

class ProxyPool:
    def __init__(self, raw_list):
        self.proxies = list(raw_list)
        self.dead = set()

    def get(self):
        alive = [p for p in self.proxies if p not in self.dead]
        if not alive:
            raise RuntimeError("池子空了,该补新IP了")
        return random.choice(alive)

    def mark_dead(self, proxy):
        self.dead.add(proxy)
        left = len(self.proxies) - len(self.dead)
        print(f"剔除失效代理 {proxy},剩余可用 {left} 个")

def fetch(url, pool, retry=3):
    for _ in range(retry):
        proxy = pool.get()
        try:
            r = requests.get(url,
                             proxies={"http": proxy, "https": proxy},
                             timeout=8)
            r.raise_for_status()
            time.sleep(random.uniform(0.5, 1.5))  # 别把节奏压太死
            return r
        except requests.RequestException:
            pool.mark_dead(proxy)   # 失败就换下一个,不硬磕
    return None
几个细节值得单独说:失败后别急着重试同一个节点,先剔除再换,省下的都是时间;sleep 用随机区间而不是固定值,节奏更接近真人;池子的补充一定要自动化——跑着跑着只剩两三个可用 IP,比没有池子还危险,因为你以为有退路,其实没有。
姿势三:Scrapy 中间件,框架级的省心方案
项目上了 Scrapy 就不用自己造轮子,写个下载中间件,把分配逻辑挂进请求生命周期:
# middlewares.py
import random

class RandomProxyMiddleware:
    def __init__(self, proxy_list):
        self.proxies = proxy_list

    @classmethod
    def from_crawler(cls, crawler):
        return cls(crawler.settings.getlist("PROXY_LIST"))

    def process_request(self, request, spider):
        # 每个请求进来都重新挑一个,形如 http://用户名:密码@ip:端口
        request.meta["proxy"] = random.choice(self.proxies)

    def process_exception(self, request, exception, spider):
        spider.logger.warning(f"代理请求失败:{request.meta.get('proxy')}")
        return request   # 交回调度器重排,下次会重新分配
settings.py 里配上几行:
DOWNLOADER_MIDDLEWARES = {
    "myproject.middlewares.RandomProxyMiddleware": 543,
}
PROXY_LIST = [
    "http://用户名:密码@ip1:端口",
    "http://用户名:密码@ip2:端口",
]
AUTOTHROTTLE_ENABLED = True   # 自动限速,配合代理用效果更好
框架方案的好处是请求级分配天然成立:每个请求进来都重新挑节点,配合自动限速,被风控盯上的概率能压到很低。任务量大的采集项目,我基本都走这条路。
池子从哪来:免费和付费的实测差距
免费代理池(各类免费代理网站、开源社区里的抓取项目)不是不能用,但要有心理预期。我拿两百个免费 IP 做过一轮测试:抓下来先验活,能通的不到四十个;跑半小时再看,还活着的剩十几个;响应时间普遍一到三秒,偶尔还碰上返回内容被中间人篡改的情况。对数据准确性有要求的任务,这种损耗根本扛不住。
| 对比项 | 免费代理池 | 付费动态池 |
|---|---|---|
| 验活后可用率 | 实测不到两成 | 接入即可用 |
| 平均响应 | 1~3秒,波动大 | 30ms级 |
| 维护成本 | 自己验活补池 | 服务端日更 |
| 数据可信度 | 偶发内容被篡改 | 自营机房直连 |
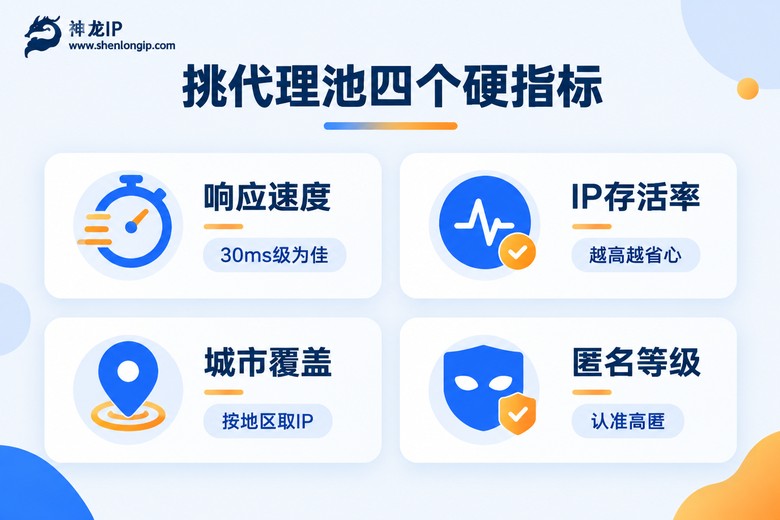
付费服务省的就是验活和维护的心力。以我在用的神龙IP为例,看中它主要是两点:一是动态高级套餐日更 200万+ IP、时效 2-360 小时可以按任务调,短任务用短时效、长任务锁长时效,中途基本不用操心节点失效;二是自营机房加 30ms 级响应,请求延迟和直连拉不开差距,日志里几乎见不到超时重试。
接入没有任何特殊写法,拿到 SOCKS5 接入信息后按姿势一的格式填进去就能跑,前面写的池子和中间件也都能直接复用。
压箱底的几个细节
请求头要像样。光有高匿 IP,User-Agent 却是 python-requests/2.x,一样会被重点关照。准备一组 UA 轮着用,Referer 该带就带。
频率悠着点。单 IP 每秒一两个请求是多数网站能接受的节奏,并发开太高,等于主动把自己暴露在风控眼皮底下。
连续 403、429 就退避。指数退避等几分钟再试,比硬磕划算得多。
日志里记下每个请求用的节点。排查问题时,这条记录能帮你省一半时间。
常见问题
Q: 高匿和普通匿名,实际差别很大吗?
差别在于对方能不能识别出"这是代理"。普通匿名会留下代理特征头,风控严格的站点会对这类请求降权或直接弹验证码。爬虫建议一步到位上高匿,省得回头排查半天。
Q: 免费代理池到底能不能用?
学语法、调脚本逻辑可以,正经任务不建议。实测存活率通常不到两成,速度慢、波动大,还有返回内容被篡改的风险。任务量一大,验活维护的时间成本比买服务还高。
Q: 代理 IP 有时效,任务跑到一半失效了怎么办?
两手准备:代码层面做失败剔除和自动重试,参考姿势二的写法;选服务时挑时效可控的套餐,比如神龙IP动态高级的 2-360 小时时效,按任务时长设定,中途补池的次数就能压到最少。
Q: HTTP 代理和 SOCKS5 代理怎么选?
只跑 HTTP/HTTPS 请求,两者体感差别不大;流量里混了其他协议,或者在意底层兼容性,选 SOCKS5 更省心。神龙IP两种协议都支持,按需选就行。