先搞清楚:你的爬虫为什么需要一个池子
写爬虫的人多半经历过这样的场景:脚本上午还跑得好好的,下午目标网站就开始返回验证页,晚上干脆全部超时。你把某一个代理IP填进 requests 里,撑了半小时又挂了。单个IP的寿命就这么长,指望一个IP从头跑到尾,本来就不现实。
代理池的思路很朴素:手里攥着一大把IP,谁挂了就换下一个,挂得多的直接扔。听起来简单,真要自己搭,坑全藏在细节里——IP从哪来、怎么知道它还活着、挂了之后怎么处理。这篇文章带你把这套东西从零写出来,代码都能直接跑。
拆开看,代理池就四个零件
很多教程一上来甩几百行代码,反而看不清结构。一个能用的代理池,拆开其实只有四个模块:
存储层:放IP的地方,要能快速写入、按分数取出,Redis 的有序集合(zset)天然适合干这个;获取层:新IP的来源,可以抓网上的免费代理页,也可以对接付费服务商的接口;校验层:拿到IP不等于能用,得真实发一次请求试试,把不可用的筛掉;接口层:给爬虫一个取IP的入口,一个轻量的 HTTP 服务就够了。
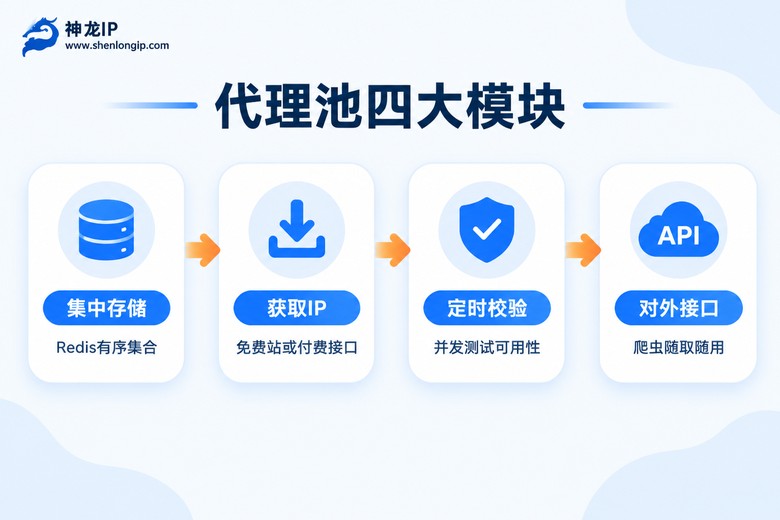
四个模块各自独立,用函数调用串起来就行。下面按顺序一个个实现。
存储层:用 Redis 有序集合给IP打分
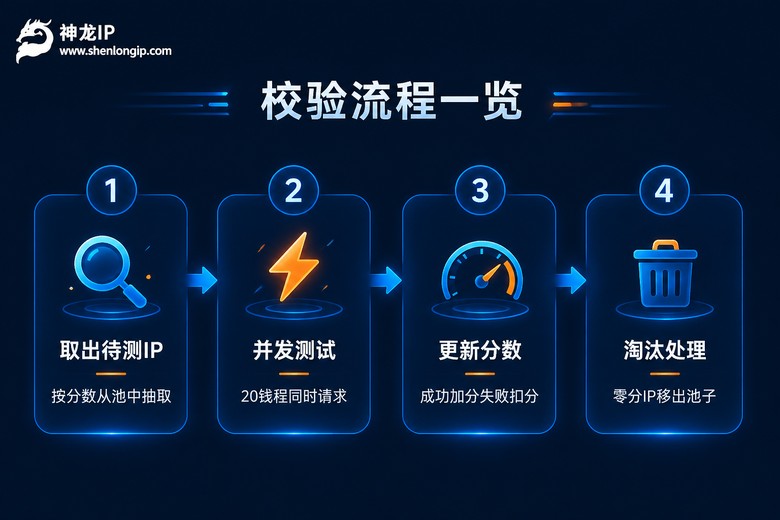
为什么不用列表或者普通集合?因为它们都没法打分,而代理池的核心维护逻辑恰恰是"分数"——好IP分高,坏IP分低,零分淘汰。Redis 的 zset 每个成员自带一个 score,加减分数都是原子操作,几十行代码就能把存储层写完:
import redis

class ProxyPool:
    def __init__(self, host='127.0.0.1', port=6379, key='proxy:pool'):
        self.r = redis.Redis(host=host, port=port, decode_responses=True)
        self.key = key

    def add(self, proxy, score=10):
        """新IP入库,默认满分10分"""
        self.r.zadd(self.key, {proxy: score})

    def get(self):
        """取分数最高的一个IP"""
        result = self.r.zrevrange(self.key, 0, 0)
        return result[0] if result else None

    def all(self):
        return self.r.zrevrange(self.key, 0, -1)

    def fail(self, proxy, deduct=1):
        """请求失败扣分,扣到0自动移出"""
        score = self.r.zincrby(self.key, -deduct, proxy)
        if score <= 0:
            self.r.zrem(self.key, proxy)

    def count(self):
        return self.r.zcard(self.key)
本地起一个 Redis(Windows 下用 WSL 或 Docker 都行),pip install redis,这段代码存成 pool.py 就能直接用。格式统一存成 IP:端口,比如 123.45.67.89:8080,后面校验和调用都按这个格式来。
校验层:并发测试,把水分挤干
免费渠道抓来的IP,十个里能用的常常不到三个,所以校验这步不能省,也不能一个一个慢慢测——几百个IP串行跑完,排在后面的早就过期了。用线程池并发,20 个线程同时测,一轮下来十几秒:
import requests
from concurrent.futures import ThreadPoolExecutor, as_completed

TEST_URL = 'https://httpbin.org/get'  # 换成任意稳定可靠的测试地址

def check_one(proxy):
    proxies = {'http': f'http://{proxy}', 'https': f'http://{proxy}'}
    try:
        resp = requests.get(TEST_URL, proxies=proxies, timeout=5)
        return proxy if resp.status_code == 200 else None
    except Exception:
        return None

def check_all(pool, workers=20):
    candidates = pool.all()
    with ThreadPoolExecutor(max_workers=workers) as ex:
        tasks = {ex.submit(check_one, p): p for p in candidates}
        for task in as_completed(tasks):
            p = tasks[task]
            if task.result():
                pool.add(p, score=10)    # 通过,分数回满
            else:
                pool.fail(p, deduct=10)  # 失败,直接扣光淘汰
两个细节值得说。一是测试地址选 httpbin 这类稳定服务,别用目标网站本身,否则校验结果会被目标站的封禁策略干扰;二是超时设 5 秒足够,一个IP如果 5 秒都响应不了,业务里也用不了它,没必要干等。
调度与接口:让爬虫随取随用
存储和校验都有了,还差两块:定时跑校验的任务,以及给爬虫用的取IP入口。定时任务用 schedule 这个小库,把上面的校验代码存成 checker.py,每 5 分钟全池测一轮:
import schedule
import time
from pool import ProxyPool
from checker import check_all

pool = ProxyPool()

schedule.every(5).minutes.do(check_all, pool)

while True:
    schedule.run_pending()
    time.sleep(1)
接口层用 Flask 起两个路由就够用:
from flask import Flask, jsonify
from pool import ProxyPool
import random

app = Flask(__name__)
pool = ProxyPool()

@app.route('/get')
def get_one():
    proxies = pool.all()
    if not proxies:
        return jsonify({'error': '池子空了'}), 503
    # 从分数前一半里随机挑,避免请求全压到同一个IP上
    top = proxies[: max(len(proxies) // 2, 1)]
    return jsonify({'proxy': random.choice(top)})

@app.route('/count')
def count():
    return jsonify({'count': pool.count()})

if __name__ == '__main__':
    app.run(host='0.0.0.0', port=5555)
在爬虫里接上池子:失败自动换下一个
import requests
import time

POOL_API = 'http://127.0.0.1:5555/get'

def fetch(url, retry=3):
    for _ in range(retry):
        proxy = requests.get(POOL_API, timeout=3).json().get('proxy')
        if not proxy:
            time.sleep(2)
            continue
        try:
            resp = requests.get(
                url,
                proxies={'http': f'http://{proxy}', 'https': f'http://{proxy}'},
                timeout=8,
            )
            if resp.status_code == 200:
                return resp.text
        except Exception:
            continue  # 这个IP不行,下一轮自动取新的
    return None
注意失败后的处理方式:不在同一个IP上重试,直接回接口拿下一个。既然是池子,就要用"池"的打法——快速失败、快速换人,比在坏IP上死磕高效得多。
维护比搭建更磨人:三个节奏要踩准
池子搭好只是开始,跑一周你会发现真正的工作量全在维护上。踩准三个节奏,池子才能长期稳定:
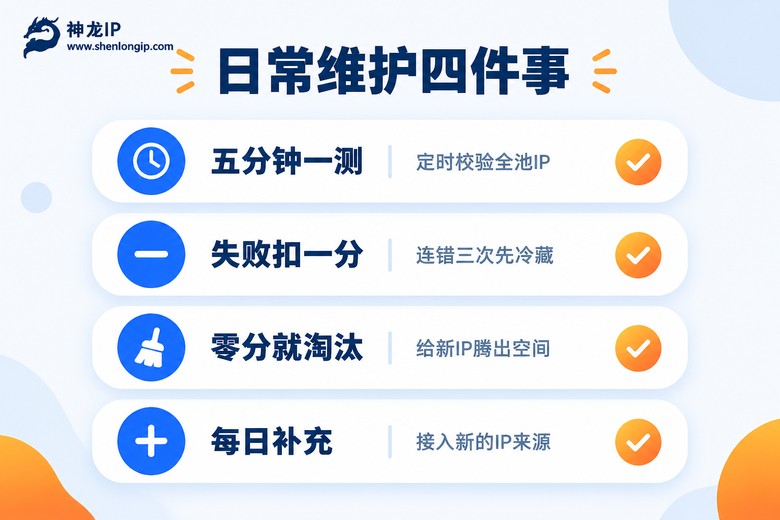
校验频率:免费IP的有效期普遍在几分钟到几小时之间,5 到 10 分钟全量测一轮比较合适。测得太勤浪费资源,太懒池子里全是"尸体"。
淘汰策略:建议"失败一次扣 1 分,连错三次先冷藏,校验不过直接清零"。比一刀切更平滑,也给偶尔抽风的IP留了一次机会。
补充节奏:每天固定往池子里补新IP,有进有出,让池子保持流动。只出不进的池子,三天就见底。
还有一个容易被忽略的指标:池子水位。给 /count 加个监控,低于 50 就告警,说明获取层出了问题——要么免费源改版了,要么接口配额用完了。
免费IP的天花板,和更省事的路子
说实话,自建池子跑免费IP,适合学习和中小规模任务。真要跑生产,免费源的三个硬伤绕不过去:可用率低(校验十次剩两三个就不错)、寿命短(经常几分钟就失效)、没法指定地区(拿到哪算哪)。两边实际用下来的差距大概是这样:
| 对比维度 | 自建免费池 | 神龙IP动态代理 |
|---|---|---|
| IP来源 | 公开页面抓取,质量参差 | 自营机房,1000万+纯净IP |
| 实际可用率 | 校验后常剩两三成 | 到手即用,30ms极速响应 |
| 地区指定 | 随机分配,拿到哪算哪 | 200+城市精准定位 |
| 维护成本 | 校验调度全要自己写 | 获取层换个接口即可 |
更划算的做法是:池子的架构原封不动,把获取层从"抓免费页"换成对接神龙IP的接口,其余代码一行不用改。我们团队后来稳定用的就是这套组合,看中它三点:自营机房直供,拿到的IP基本都能直接跑,30ms 的响应对采集任务提速很明显;200+城市可以按需指定,需要哪个地区的IP就取哪个地区的;动态高级套餐支持 2-360 小时的时效设置,任务跑多久IP就活多久,中间不用操心失效重连。
接入也简单:服务商提供一个返回IP列表的提取接口,你在获取层定时拉一次,写进 Redis 就行——前面写的所有代码全部复用。协议上支持 SOCKS5 等常见类型,requests、Scrapy 都能直接对接。
常见问题
Q: 不用 Redis,用 SQLite 或者内存字典行不行?
行,但都有代价。内存字典重启就丢,SQLite 在高频并发校验下容易锁表。Redis 的 zset 自带打分和原子操作,几十个到几十万个IP的规模都能扛,是最省心的选择。
Q: 校验通过了,业务里用还是失败,怎么回事?
大概率是校验和业务的环境差异:校验时只是 GET 一个简单页面,业务里可能带 Cookie、POST 大数据,或者目标站对这个IP的风控更严。把校验地址换成业务同源的轻量接口,测出来的结果才贴近真实。
Q: 池子里IP数量越多越好吗?
不是。数量堆上去但校验跟不上,等于在垃圾堆里翻IP,反而拖慢业务。重点看"校验后的可用数量",500 个高分的活IP,比 5000 个不测的IP好用得多。
Q: 神龙IP的动态高级和动态独享套餐怎么选?
区别在带宽和独占性:动态高级峰值 6Mbps,日更 200万+ IP,适合常规采集任务;动态独享峰值 10Mbps,IP 独享不与他人共用,适合对速度和稳定性要求更高的场景。两个套餐时效都是 2-360 小时可设,建议先小规模试跑一天,看实际可用率再定。