先别急着下结论:延迟到底卡在哪一段
接入代理IP后,很多人第一反应是“会不会变慢”。这个问题不能只看一个数字。延迟可能是本地出口不稳,可能是线路在高峰时段排队,也可能是节点负载偏高,甚至只是目标地址本身响应慢。真正有用的判断,是把整条路径拆开看:从本机到节点,从节点到目标地址,中间每一段的耗时和丢包都要有记录。
我通常会先做一个简单基线:不经过代理,直接请求同一个目标地址,记录 20 次耗时;再接入代理节点,重复同样次数。两边数据放在一起,才能看出代理带来的额外开销。如果基线本身就有 80ms,后面再叠加 30ms,体验自然会更明显。
延迟的四个常见来源
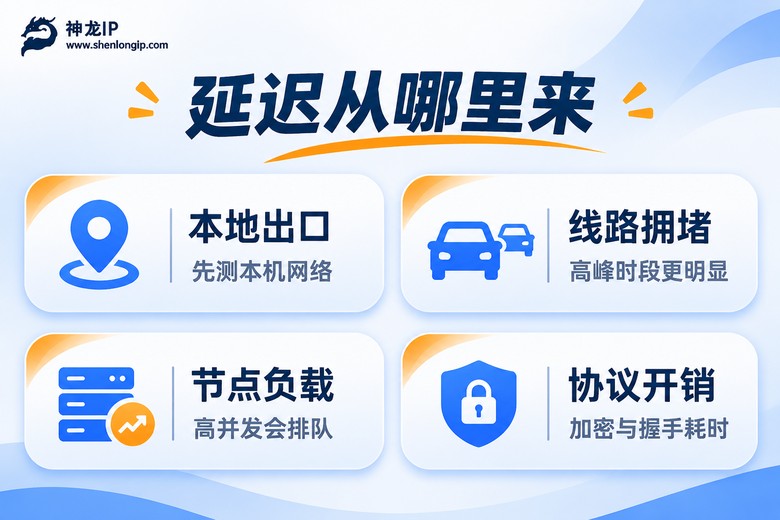
本地出口是最容易被忽略的一段。家里宽带的晚高峰、公司出口带宽被占满、Wi-Fi 干扰,都会让首包时间变长。判断方法很简单:同一台机器、同一时间,先测直连,再测代理。如果直连就已经不稳定,后面再怎么挑节点,也很难把体验拉回来。
线路拥堵更像“路上车多”。节点距离近不一定永远快,因为中间路由可能经过繁忙交换点。高峰时段,同一条线路的 P95 延迟可能比 P50 高出很多。做判断时,不要只看平均值,最好把 95 分位耗时也写进记录。
节点负载决定节点能同时处理多少请求。节点空闲时,延迟稳定;请求量上来后,排队时间会增加。表现往往是:单个请求还正常,但并发一高,耗时就开始飘。做压测时,可以固定并发数,连续跑 20 到 50 次,看延迟曲线是否出现台阶式上升。
协议开销相对固定。SOCKS5 这类代理协议需要握手和转发,加密链路也会增加一点处理时间。这部分通常不会忽高忽低,如果延迟波动很大,更多要怀疑线路、节点负载或本地出口。
节点优化怎么做:从实测到稳定
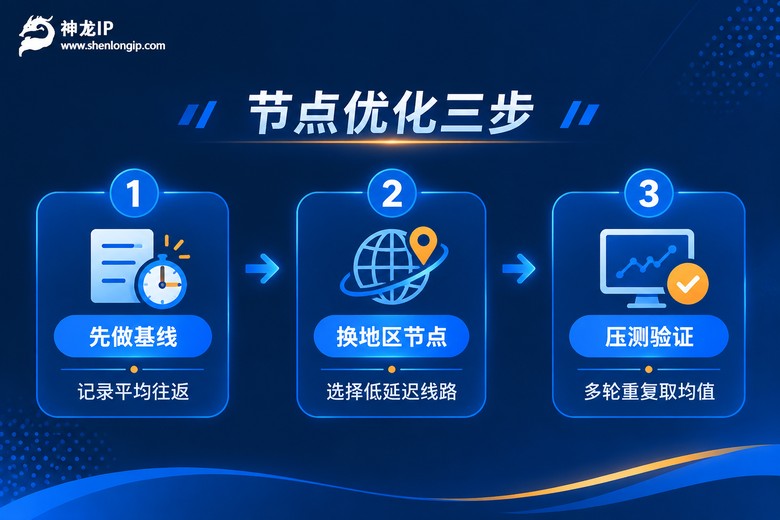
节点优化不是“挑一个最近的地方”这么简单。更稳的做法是把变量固定住,再逐步替换。第一步,先做基线。记录本机直连的平均延迟、P95、丢包率。第二步,换地区节点。选择距离业务目标地址较近、线路跳数少、负载低的节点。第三步,压测验证。用同一组请求,连续跑多轮,取均值和分位值,而不是只测一次。
# 把 节点IP 替换成你当前使用的地址
ping -c 20 节点IP

# 看路径上哪一段跳数变多、哪一段耗时变高
traceroute 节点IP
如果 ping 稳定但业务请求慢,重点看应用层:目标地址是否有限速、是否返回慢、是否要求更长的连接保持时间。如果 ping 和请求都慢,再回头查线路和节点负载。下面是一组常见场景的参考数据,用来理解延迟差异。
| 场景 | 平均延迟 | P95延迟 | 丢包 | 说明 |
|---|---|---|---|---|
| 本地直连 | 12ms | 18ms | 0.1% | 作为基线 |
| 同区代理节点 | 28ms | 39ms | 0.3% | 路径短,波动小 |
| 跨区代理节点 | 46ms | 72ms | 1.1% | 跳数增加 |
| 高峰时段 | 68ms | 112ms | 3.2% | 拥塞更明显 |
这张表想说明的是:代理IP一定会增加路径,但是否“明显延迟”,取决于节点质量、线路状态和业务目标。同区节点通常更容易控制在较低延迟,跨区节点则要接受更高基线。高峰时段的数据尤其值得记录,因为它能反映线路的真实承压能力。
怎么判断神龙IP节点是否适合业务
如果你正在做节点筛选,可以把神龙IP的 30ms极速响应作为筛选条件之一。对延迟敏感的业务,节点响应越快,越容易把额外延迟控制在可接受范围内。比如做各地搜索排名测试时,稳定的节点基线能减少干扰;做服务器性能与压力测试时,也能让对照数据更干净。
如果业务经常需要获取新的IP,动态高级套餐的日更200万+IP和 2-360小时时效会更灵活,适合数据采集与IP轮换场景。这里不用把节点想象成“越快越好”,关键是你的业务能接受多少额外延迟,以及延迟是否稳定。
常见问题
Q: 代理IP一定会比直连慢吗?
通常会多一段路径,所以平均延迟会比直连高。但具体差多少,要看本地出口、线路拥堵、节点负载和协议开销。选对节点后,很多场景下额外延迟可以控制在可接受范围内。
Q: 延迟高就一定不能用了?
不一定。有些业务对实时性要求高,比如在线互动类场景,延迟敏感;有些业务更看重IP独立性和地区覆盖,比如各地搜索排名测试,延迟只要稳定,就可以接受。关键是把 P50、P95 和丢包一起看。
Q: 怎么快速判断是节点问题还是本地网络问题?
同一时间测直连和代理。如果直连也波动大,先处理本地出口;如果直连稳定、代理波动大,再查节点负载、线路跳数和协议开销。连续测 20 次比单次结果更可靠。
Q: 节点优化时最该记录哪些数据?
至少记录平均延迟、P95延迟、丢包率、并发数和测试时间。固定目标地址、固定请求次数、固定并发,再更换节点做对照,才能看出节点差异,而不是被偶发波动误导。