前阵子有个做数据采集的朋友找我,说脚本第一天跑得好好的,第二天开始十个页面里有六个弹验证码,剩下的直接超时。他第一反应是"代理不够多",于是又买了一堆,结果第三天连登录都登不上了。问题根本不在数量,而在他压根没想过自己用的是哪种轮换方式——一条 IP 用多久、什么时候换,这个节奏没对上任务,买再多也是白搭。
自动轮换 IP 这件事,软件界面上往往就一个下拉框,写着"按时间"和"按请求"。看起来是选择题,实际是两种完全不同的工作方式。这篇就把这两种方式拆开讲,顺便说说挑软件时到底该盯哪几个参数。
先想清楚:你的任务怕不怕被"串起来"
判断该用哪种轮换,先问自己一个问题——你这一串操作,需不需要让对面觉得"还是同一个人在操作"?
举个具体的。你要抓一个电商站点的商品详情,从列表页点进详情页、翻规格、看评论,中间有跳转、有参数、偶尔还要维持一个临时会话。这种情况下,如果每发一个请求就换一条 IP,对面看到的就是"同一个浏览行为,来自十几个不同城市的设备",比不换还显眼,页面大概率直接给你空白。
反过来,你在做一个关键词在各地搜索结果的排名测试,要查 200 个城市、每个城市几十个词。这些请求彼此之间毫无关系,一个请求和下一个请求之间也不需要任何上下文。这时候你要是还用一条 IP 慢慢跑,跑到一半就被限速了。
所以顺序是:先定任务形态,再定轮换方式,最后才谈软件和套餐。别倒过来。
定时轮换:到点交班,好控制也好复盘
定时轮换的逻辑很朴素:设一个周期,比如 60 秒、5 分钟,或者"一条 IP 用满 N 次就换"。周期一到,软件自动去池子里拿一条新的,接着干。
它的好处是节奏完全在你手里。出问题的时候,你能明确说出"第 3 分钟那批请求用的是哪条 IP",日志一对就清楚,不像请求级轮换那样,几百条 IP 混在一起根本追不回来。
参数怎么定?我一般的做法是拿单次请求的耗时去推。假设抓一个页面平均 2.5 秒,你希望一条 IP 上跑 8 到 10 个页面,那周期就设在 20 到 30 秒左右,别卡得太死。周期设得太短,等于没享受到会话延续的好处,还白白多消耗 IP;设得太长,一条 IP 上堆积的请求数上去了,被限的概率也跟着上去。
import time, requests

# 从后台复制出来的那条代理,形如 http://用户名:密码@地址:端口
s = requests.Session()
s.proxies = {"http": PROXY, "https": PROXY}

def fetch_new_proxy():
    """调取 IP 的接口,返回一条新的代理地址"""
    ...

PAGES_PER_IP = 8      # 一条 IP 跑满 8 个页面就换
count = 0

for url in url_list:
    if count >= PAGES_PER_IP:
        s.proxies = {"http": fetch_new_proxy(), "https": fetch_new_proxy()}
        count = 0
        time.sleep(1)          # 换完之后缓一下,别贴着上一个节奏走
    resp = s.get(url, timeout=15)
    count += 1
有个小细节很多人忽略:换了 IP 之后别立刻发请求,中间停 1 秒左右。太整齐的"旧 IP 最后一次请求 → 新 IP 第一次请求"间隔,本身就是一种特征。
请求级轮换:一次请求换一个身份
请求级轮换是另一个极端——每发一个请求之前,先去拿一条新 IP,用完就丢。适合那种请求量大、单个请求又短又独立的工作,比如按城市逐个查搜索结果、按关键词逐个取公开列表数据。
代价是 IP 消耗快。一天 20 万次请求,那就是 20 万条 IP,对代理池的日更新量要求很直接:池子不够大、更新不够勤,你拿到手的就是一批重复的、甚至已经被用烂的地址,错误率会肉眼可见地往上涨。
for url in url_list:
    proxy = fetch_new_proxy()        # 每个请求前重新取一条
    try:
        resp = requests.get(url, proxies={"http": proxy, "https": proxy}, timeout=15)
    except requests.RequestException:
        proxy = fetch_new_proxy()    # 失败了丢掉重取一条,别死磕
        resp = requests.get(url, proxies={"http": proxy, "https": proxy}, timeout=15)
这种模式下有两个地方必须做:一是失败重试只重试一次,重试太多次反而拖慢整体节奏;二是记录每条 IP 的成败,连续失败两三次的直接拉进黑名单,别让它反复出现在池子里。
摆在台面上比一比
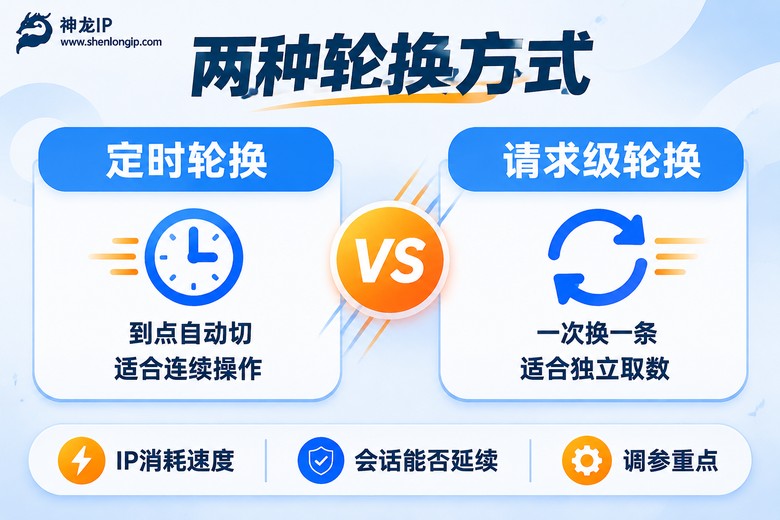
把两种方式的关键差别列出来,对照着自己的任务看,基本五分钟就能定下来用哪个。
| 对比维度 | 定时轮换 | 请求级轮换 |
|---|---|---|
| 什么时候换 | 到时间或到次数触发 | 每次发请求前换 |
| IP 消耗速度 | 慢,一条用一段时间 | 快,一次一条 |
| 会话能否延续 | 周期内可以延续 | 基本延续不了 |
| 适合的任务 | 要连续点击、翻页、登录的流程 | 彼此独立的取数类请求 |
| 被关联的风险 | 周期太规律容易被看出 | 相对更低 |
| 调参重点 | 周期与单次耗时对齐 | 取 IP 速度与失败重试 |
| 对代理池要求 | 稳定即可 | 日更新量要大、纯净度要高 |
还有一种混合打法,实际项目里用得不少:主体用定时轮换,遇到被拦的页面临时切请求级。既能保住大部分流程的连续性,又能在硬骨头上换个身份再试一次。
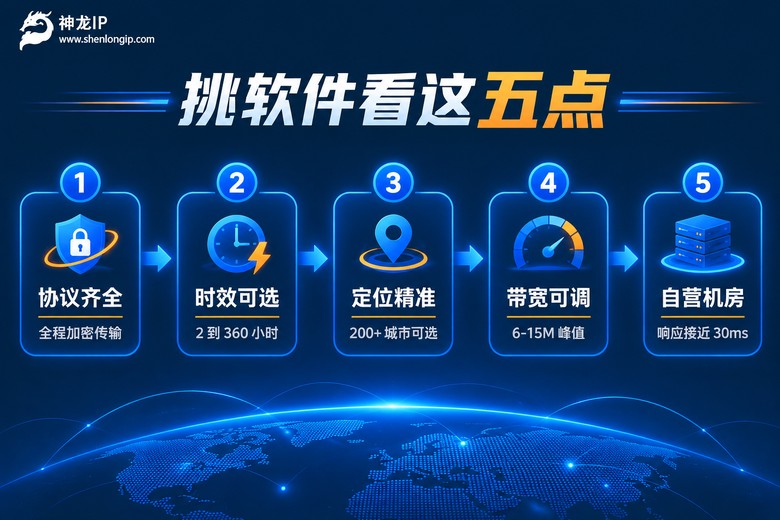
挑软件时,我只看这五条硬指标
市面上标着"自动轮换"的工具很多,但能真正落到可控的没几个。我自己的检查顺序是这样的:
第一,协议是不是齐全。至少要覆盖 SOCKS5、L2TP、PPTP、SSTP、IKEv2 这几种,因为不同语言、不同工具链对接的方式不一样,只有一两种协议,换个采集框架就得重新折腾。同时要确认数据传输全程加密,别用明文裸跑。
第二,时效范围够不够宽。能选的时效最好覆盖 2 到 360 小时这个跨度,短任务用短时效,长任务用长时效,不用为了一个需求去开两套东西。
第三,能不能按城市取。做各城市的搜索排名测试,这一条是刚需——只能给你"随机某地"的软件,等于没法做对比。
第四,带宽峰值和并发。看你高峰时段同时开多少个线程,峰值不够就会卡在你自己的瓶颈上,跟 IP 质量没关系。
第五,能不能单条取、能不能报错剔除。API 支持一次取一条、失败能立刻重取,这是请求级轮换能不能跑起来的前提。
选哪一档,其实取决于你要哪种轮换
把上面几条对着神龙IP 现有的几个套餐看,对应关系其实挺清楚,不用纠结:
跑请求级轮换、一天消耗量大的,看动态高级。它的池子是日更 200 万+ IP、总量 1000 万+ 纯净 IP,峰值带宽 6Mbps,时效 2 到 360 小时可选。这个更新频率配请求级轮换才算能撑住,不然你切得越快、撞上重复地址的概率越高。
跑定时轮换、同时开线程稍微多一点的,看动态独享。峰值带宽到 10Mbps,时效同样是 2 到 360 小时,资源不跟别人挤,高峰时段的表现更平一些。
如果你的任务本质上是要长期保持同一个身份——比如自媒体多账号的 IP 独立防关联,账号得长期挂在固定的一处出口上,那就别用轮换,直接上静态高级,长期固定 IP、运营商合作资源、6Mbps,稳定比什么都重要。
另外两个容易被忽略但很实用的点:一是 200+ 城市的精准定位,做各地搜索排名测试时能直接指定;二是自营机房,响应能压到 30ms 左右,脚本跑起来等待时间明显短一截,一天下来省的时间很可观。
常见问题
Q:定时轮换的间隔设多少秒比较合适?
没有标准答案,按单次请求耗时倒推。单页平均 2 到 3 秒的,设 20 到 30 秒、一条 IP 跑 8 到 10 个请求比较稳;单页要 10 秒以上的重页面,周期就放到 60 秒左右。设完之后跑半天看错误率,高了就缩短,低了就试着拉长,找到一个省钱又不被拦的平衡点。
Q:两种轮换能不能在同一个项目里一起用?
可以,而且很常见。主流程用定时轮换保持连续,遇到返回验证码或空页面的,标记下来,单独用请求级轮换重跑一遍。这样既不会为了几个难啃的页面把整体节奏打乱,也不会因为一条 IP 死磕到底。
Q:换了 IP 还是被拦,是不是代理质量不行?
先别急着怪代理。按这个顺序排查:一是请求头有没有跟着一起变,UA、语言、时区跟 IP 所在地对不上,一眼就露馅;二是请求间隔是不是过于均匀,固定 500 毫秒一次太机械;三是同一段逻辑是不是在一分钟内重复了太多次。这三点都排除了,再去看 IP 的纯净度和更新频率。
Q:什么时候该用静态 IP,而不是自动轮换?
当你需要"长期是同一个人"的时候。账号登录、后台操作、需要保持登录状态的长期任务,都属于这类。频繁更换出口反而会让平台觉得异常。判断标准很简单:这个任务如果中途换了出口会不会失败?会,就用静态。