有个朋友接了个新项目,头一周干的活特别枯燥:把同一批商品页面在十几个城市各打开一次,记下价格、库存、推荐位顺序。手动点了两天,第三天开始弹验证码,图片拼图、滑块、点字全来了。他第一反应是"网坏了",重启路由、换浏览器、清缓存,折腾一下午没解决。
问题不在网,也不在浏览器。是他用同一个出口IP,在很短时间内重复了太多次同样的动作。网站那边看到的是"同一个地址、同一套参数、一模一样的行为节奏",自然会拦一下。
这时候代理IP的价值才显出来。但也别把它想得太神,它做的事其实很朴素——给你的请求换一条出口。
一、代理IP到底动了哪一根线
平常上网,你的请求从家里的宽带出去,网站记录下的是这条宽带的地址。挂上代理之后,请求先发到代理服务器,再由那台服务器替你发出去,网站记下的是服务器的地址。所以所谓"换IP",换的是出口,不是你的设备、你的账号、你的浏览器。
理解这一点很关键,后面所有用法都建立在这上面:代理只换出口,不换行为。你节奏还是那么急、请求还是那么密,照样会被识别;反过来,出口分开了、节奏也放慢了,很多原本卡住的操作就顺了。
| 对比项 | 直接连 | 走代理 |
|---|---|---|
| 网站看到的来源 | 你本地的出口IP | 代理服务器的IP |
| 能否指定城市 | 不能,看宽带归属 | 能,按城市挑选 |
| 连续请求的识别难度 | 低,一个地址反复出现 | 高,可分散到多个地址 |
| 适合做的事 | 日常浏览、后台管理 | 多城市核对、数据采集、多账号隔离 |
二、访问环节:同一张页面,隔条江就是另一个样子
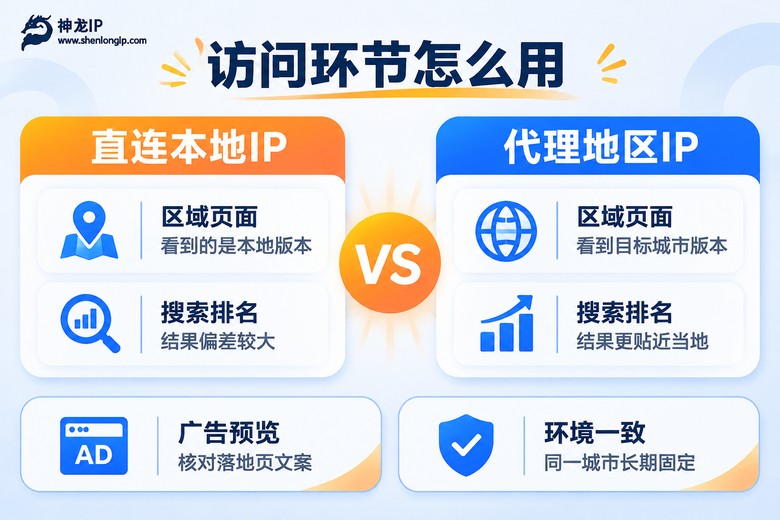
很多人第一次被代理IP"教育",是在做页面核对的时候。电商详情页的价格、满减门槛、库存状态、默认收货城市,各家都是按地区算的;搜索引擎的排序结果,也会因为来源城市不同而出现明显差异。你在办公室看首页第一屏是A商品,换到另一个城市看,第一屏可能变成B商品。
做投放的同学应该更有体会。素材上线前要核对落地页文案对不对得上,可你自己看的那一版,往往不是目标城市用户看到的那一版。文案里写的"今日达",在你的城市是次日,在别的城市可能是三日。
具体怎么操作,其实就三步:
第一步,在代理工具里按城市挑一条线路,比如你要看的是成都,就选成都的出口,不要图省事选个就近的。神龙IP这边能覆盖200+城市做精准定位,选城市这个动作是精确到具体城市的,不是大区。 第二步,浏览器开一个干净的无痕窗口,把缓存和Cookie都清掉,不然旧的城市参数还留着。 第三步,打开目标页面,截图、记录,再换下一个城市重复。
还有一个容易被忽略的点:如果这项核对是长期活儿,比如每周都要看一次重点城市的呈现,那就别用每天变来变去的地址。静态高级这类长期固定IP更合适,同一个城市、同一个出口,几次对比下来变量就只剩下页面本身,判断起来干净。
三、采集环节:不是"能不能采",是"采得稳不稳"
数据采集被拦,九成不是技术问题,是节奏问题。对方的风控大致看三件事:这个IP在单位时间内请求了多少次、这个IP是不是在共享的黑名单里、这个IP同时在跑多少条连接。
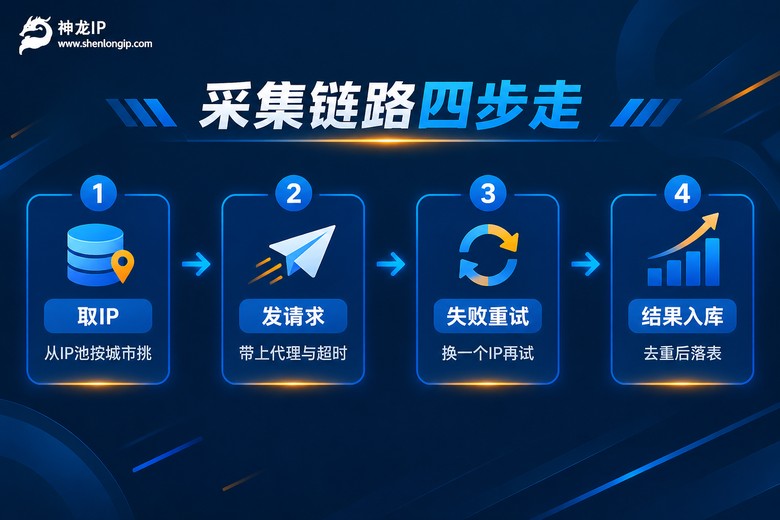
所以采集端的代理策略,核心不是"用不用代理",而是怎么分配IP、什么时候换。一个比较稳的链路是这样搭的:
import requests, random, time

ip_pool = [
    "http://用户名:密码@代理地址1:端口",
    "http://用户名:密码@代理地址2:端口",
    "http://用户名:密码@代理地址3:端口",
]

def fetch(url, retry=3):
    for i in range(retry):
        proxy = random.choice(ip_pool)
        try:
            r = requests.get(
                url,
                proxies={"http": proxy, "https": proxy},
                headers={"User-Agent": "Mozilla/5.0 ..."},
                timeout=8,
            )
            if r.status_code == 200:
                return r.text
        except Exception:
            pass
        time.sleep(1.5)   # 换IP前先停一下,别立刻怼上去
    return None

for page in range(1, 51):
    html = fetch(f"https://目标站点/list?page={page}")
    if html is None:
        print("这一页放弃,稍后补")
    time.sleep(random.uniform(1, 3))
几点现场经验,比代码本身值钱:
超时要设短。8秒拿不到就换,别让它一直挂着占连接。失败重试不超过3次,同一个地址第三次还不行,说明这个出口被盯上了,换掉比死磕划算。两次请求之间留一两秒的随机间隔,比把并发开到一百条更容易出数据。把这些细节做对,成功率往往比单纯堆IP数量提升得更明显。
如果你的采集要跑好几天,用动态高级这类时效可选(2-360小时)的套餐会省心,日更200万+IP的量池,6Mbps峰值,够中小规模的定时任务用;要是并发更高、对单条通道要求更宽,动态独享的10Mbps峰值更合适,而且独享意味着这条通道不跟别人混在一起,不会因为别人的节奏把你带着一起被限。
| 采集场景 | 建议的IP用法 | 换IP节奏 |
|---|---|---|
| 几十个页面的小批量核对 | 少量固定地址轮着用 | 每30-50次请求换一次 |
| 持续数天的定时任务 | 按城市分配地址池 | 每轮任务换一批 |
| 页面结构复杂、要多次点开 | 单IP低并发,靠时间换稳定 | 失败即换,不重试过多 |
| 对同一账号做连续操作 | 同一个地址自始至终不换 | 不换,保持一致性 |
四、风控环节:它看的从来不只是IP
很多人以为被封是IP的问题,换个地址就没事了。实际上平台判断异常通常看四层:出口IP、设备指纹、行为节奏、账号之间的关联痕迹。
代理IP负责的是第一层和第四层。一个运营几个自媒体账号的人,如果所有号都在同一个出口下登录、发文、看数据,平台很容易把这些号归到一堆里去;各自分配独立、稳定的出口之后,账号之间的"物理距离"拉开了,误伤率明显下降。这也是很多做矩阵的团队最先补的一课。
但另外两层得自己管。设备指纹这块,浏览器指纹、字体列表、时区、语言,最好和IP所在的地区对得上——挂着成都的出口,系统语言却是英文、时区设在别的洲,这本身就不合理。行为节奏更简单:真人不会三秒点一次、连点两百次。该停就停,该慢就慢。
顺序别搞反:先把行为做正常,再谈IP够不够用。行为乱了,给你一百个干净地址也一样会被识别。
五、选型环节:四件事对上了,就不用纠结
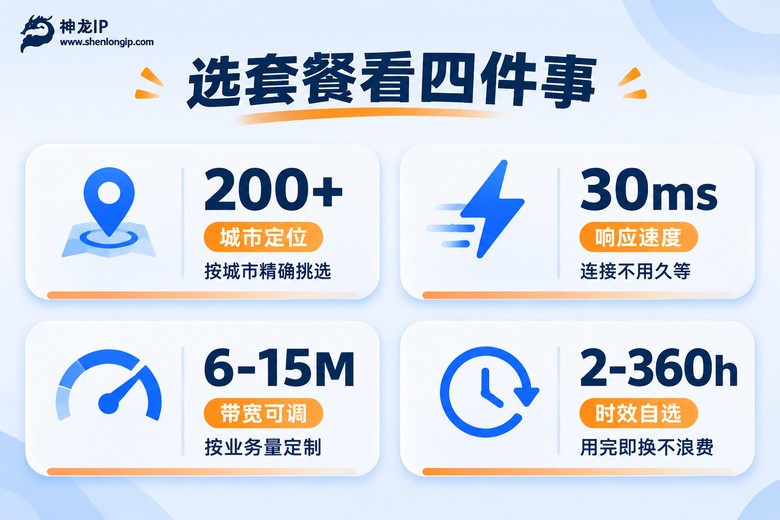
市面上的代理产品名字五花八门,其实落到参数上就那么几项:能选多少个城市、响应有多快、带宽够不够、地址能留多久。神龙IP的套餐一共四种,对应四种不同的活儿——
| 套餐 | 关键参数 | 更适合谁 |
|---|---|---|
| 充值套餐 | 按需充值,灵活起步 | 刚上手、用量不稳定 |
| 动态高级 | 6Mbps峰值、日更200万+IP、2-360小时时效 | 定时采集、多城市页面核对 |
| 动态独享 | 10Mbps峰值、2-360小时时效 | 并发偏高、要求通道独立 |
| 静态高级 | 长期固定IP、运营商合作资源、6Mbps | 账号环境长期一致、需要固定出口 |
带宽这块补充一句,6-15M是可定制的。有人一上来就买最大的,结果业务量根本撑不满,白花钱;也有人图便宜买了小的,然后抱怨采集慢——其实慢的不是代理,是通道堵了。先算清自己高峰时段要跑多少条连接,再选带宽,顺序对了就不会返工。
另外协议支持得看全:IKEv2、PPTP、L2TP、SSTP、SOCKS5 这几种都支持,意味着不管你手上是现成的客户端、脚本,还是某套工具默认走SOCKS5,基本都能直接接上,不用为了一个协议卡住。数据传输全程加密这点也别忽略,尤其是多账号运营,登录信息在链路上暴露的风险得提前掐掉。
常见问题
Q:代理IP会不会让网速变慢?
会有一点,但通常不夸张。多了一跳转发,延迟增加几十毫秒是正常的。神龙IP这类响应能到30ms左右的产品,日常打开页面、跑脚本基本感觉不出来。如果你的任务本来就慢,先查自己设的超时和重试逻辑,再看带宽是不是不够。
Q:用代理IP会不会影响我自己账号的安全?
关键看怎么用。给某个账号长期分配一个固定地区的出口,环境反而更稳定;但如果今天用这个城市、明天换那个城市,同一个账号的登录地点一直在跳,平台自然会多问两句。要长期用的账号,建议配静态高级这类长期固定IP,别频繁变动。
Q:采集的时候,IP越多越好吗?
不一定。IP多解决的是"分散"问题,但节奏太急、并发太高,再多地址也会被一起识别出来。实践中更有效的做法是:地址够用就行,把间隔拉开、把失败重试限制住、把超时压短。三个细节调好了,用更少的IP反而能拿到更稳的结果。
Q:怎么判断自己到底需不需要代理IP?
做个简单的自测:如果只是日常浏览页面、管管自己的后台,完全不需要;如果你需要按城市看不同版本、要做定时数据采集、或者手上几个账号得各自独立地登着,那基本就绕不开。神龙IP这边可以先从充值套餐起步试试,跑通了再按业务量上动态或静态,不用一次押太大。