动手之前,先把三件事算清楚
见过太多人第一反应是去搜免费代理列表,扒下来两千个IP扔进一个txt文件里,脚本一跑,十分钟后整屏都是红的。问题不在脚本,在于压根没想清楚要什么。
开工前先回答三个问题,答案会直接决定你后面怎么设计。
第一,一天要跑多少条请求。如果只是几千条,随便写个轮询就够用;如果要跑到几十万条,就得考虑IP的日更能力和带宽够不够,不然你自己维护的那点IP池撑不到下午就干了。
第二,目标页面对异常请求敏不敏感。有的站只看访问频率,换个IP就放行;有的会看IP属于哪个网段、是不是机房段。前者靠轮换就能解决,后者必须在IP纯净度上下功夫,来源杂的免费IP基本没戏。
第三,需不需要指定城市。做本地生活类信息采集、各地搜索排名对比的,往往要求从这个城市发起请求。这时候IP池里存的不能只是"IP:端口",还得带地域标签,不然拿到的数据对不上号。
把这三个数写在本子上,后面的代码才有得写。
一个能用的代理池,其实就四个零件
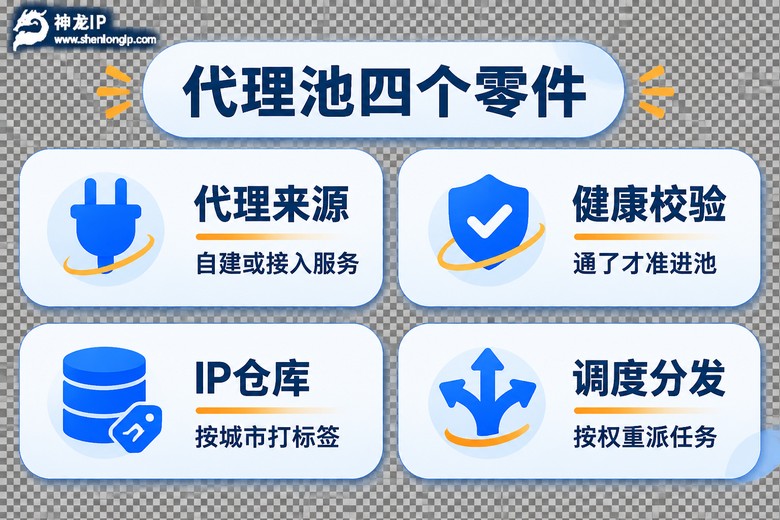
别被"池"这个字唬住。拆开看,它干的事就四件:拿到代理、确认能通、存起来备查、派出去干活。任何一套采集系统,不管代码写得多花哨,底下都是这四件。
零件一:代理来源。要么自己攒机器,要么接服务商的接口。自己攒的话,除了机器成本,还要应付IP失效、被封、网段被拉黑这些日常;接服务商则是拿账号换接口,把心力放在业务逻辑上。小团队建议直接走后者,除非你的团队里有人专门盯这块。
零件二:健康校验。新拿到的IP不能直接进池,得先探一次。探的方法很简单:用一个轻量的目标页发一次请求,超时就丢,返回正常才留。这里有个细节——别拿自己的主站目标页去探,白送一次异常请求,反而容易引起注意。用一个结构简单、响应快的第三方页面做探活就够。
零件三:IP仓库。不要只存字符串。至少四列:地址端口、协议类型、所属城市、最近一次可用时间。城市这一列决定你后面能不能按地域取IP。
零件四:调度分发。谁用、什么时候用、用多久、用完还不还回来。这部分是最容易写乱的地方,单独拎一节讲。
| 对比项 | 自己攒机器 + 免费IP | 接入代理服务 |
|---|---|---|
| 前期投入 | 找机器、写校验、天天修 | 拿到账号就能调 |
| IP可用率 | 来源杂,半天掉一半 | 自营机房,纯净度可控 |
| 地域覆盖 | 看运气 | 可按城市挑 |
| 适配节奏 | 适合长期养、有专人盯 | 适合快速上线、中小团队 |
调度:别让同一个IP连着打十次
调度这层最常见的错误,是写了个 random.choice(proxies) 就收工。随机抽有两个坑:同一个IP可能在短时间内被抽中多次,而你毫无察觉;另外失效IP还躺在池子里,一直有概率被抽出来挨打。
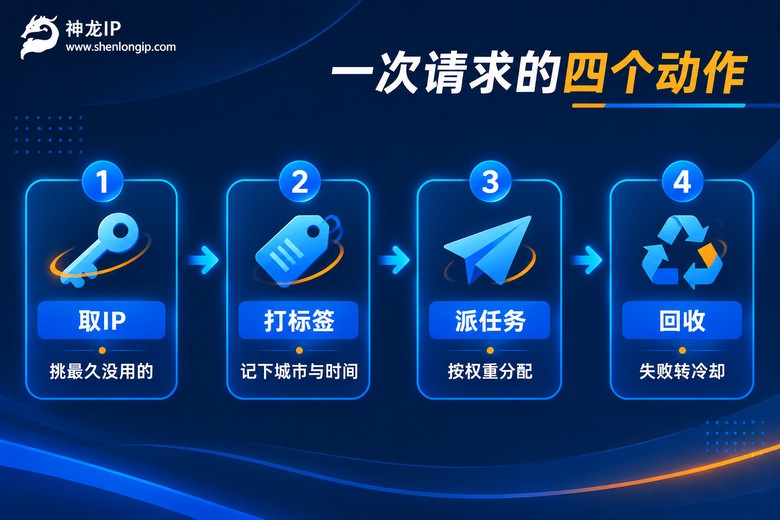
比较稳的做法是按"最久未使用"取。每次派发时,从当前可用列表里挑出上次使用时间最早的那个,同时要求它离上次使用已经隔了N秒。N取多少看目标站点的容忍度,一般3到10秒是个安全区。这么一改,同一个出口连着打的情况基本消失。
再往上一层,可以加权重。给每个IP记一个近期成功率,成功率高的多派几次,连续失败的直接打入冷宫。实现上不用多复杂,一个字典记 fails 就够,超过三次失败就从可用列表里摘掉,隔一段时间再放出来试一次。
限速要跟并发一起考虑。很多人把并发开到50,以为能快5倍,结果目标站点直接返回一堆429,连带着几个好IP一起被拉黑。正确的顺序是先定单IP频率上限,再乘上IP池规模,得到合理的并发数。池子只有20个可用IP,并发开到50就是自杀。
还有一个容易被忽略的点:失败重试要换IP。很多脚本重试三次用的是同一个代理,等于是给目标站点送三次异常信号。正确的做法是失败一次就标记、归还、换下一个,同时把这次失败记到该IP的账上。
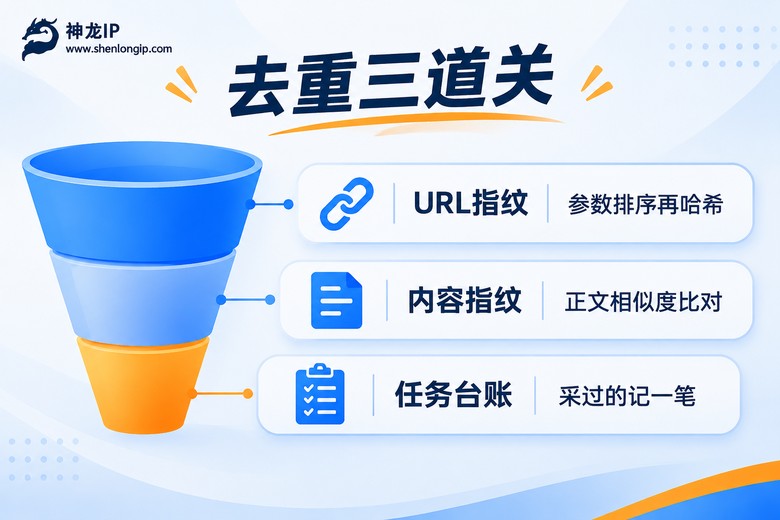
去重:三道关,能省下一半无效请求
采集项目跑着跑着数据涨得飞快,一查库,一半是重复的。这不只是浪费流量,还白白消耗了IP池的寿命——每个重复请求都要用掉一次IP配额。
第一道关:URL指纹。同一个页面,链接的写法可能有五六种:参数顺序不同、带着一串utm来源标记、末尾多一个斜杠、带个锚点。抓取前先做归一化:域名和路径转小写、路径末尾斜杠去掉、查询参数按字母排序、砍掉utm_source/spm这类无意义参数,最后对整理好的字符串做一次哈希,拿哈希去当唯一键。
第二道关:内容指纹。URL不一样,内容却可能一样。比如翻页参数变了但返回的是同一页,或者详情页和列表页里有大段重复文案。这时提取正文文本,去空白、去标点,再做一次相似度比对。简单点用正文的哈希值直接比,严格一点上SimHash,海明距离小于3就当重复处理。实际项目里,第二道关通常能筛掉5%到15%的重复,量越大越明显。
第三道关:任务台账。这一层管的是"这次跑完了,下次别再跑"。在数据库里建一张表,把归一化后的URL哈希设成主键,插进去就代表"这个任务已经被认领"。用 INSERT IGNORE 这种写法,插入成功才去采集,插入失败说明别人已经领了,直接跳过。多个进程同时跑也不会撞车。
三道关上完,你的请求量大概能降三到五成。省下来的IP配额,够多跑好几轮。
一份能跑的骨架,先跑通再优化
下面这段不追求性能,只保证逻辑清楚,你可以在此基础上加并发、加日志、接数据库。
代理池本体,核心是"取最久没用的"和"失败三次就下线":
import time
from collections import defaultdict

class ProxyPool:
    def __init__(self, max_fail=3):
        self.max_fail = max_fail
        self.alive = {}                 # ip -> 上次确认可用的时间
        self.fail = defaultdict(int)    # ip -> 连续失败次数
        self.used = {}                  # ip -> 上次被派发的时间

    def add(self, ip_list):
        for ip in ip_list:
            self.alive.setdefault(ip, 0)

    def pick(self, gap=3):
        now = time.time()
        pool = [ip for ip in self.alive
                if now - self.used.get(ip, 0) > gap
                and self.fail[ip] < self.max_fail]
        if not pool:
            return None
        # 优先用最久没派出去的,避免同一个出口连打
        ip = min(pool, key=lambda x: self.used.get(x, 0))
        self.used[ip] = now
        return ip

    def report(self, ip, ok):
        if ok:
            self.fail[ip] = 0
            self.alive[ip] = time.time()
        else:
            self.fail[ip] += 1
            if self.fail[ip] >= self.max_fail:
                self.alive.pop(ip, None)
URL 归一化,这一段决定了第一道去重关能不能过:
from urllib.parse import urlsplit, parse_qsl, urlencode

DROP = {"utm_source", "utm_medium", "utm_campaign", "spm", "from"}

def url_key(url):
    parts = urlsplit(url.strip().lower())
    path = parts.path.rstrip("/") or "/"
    query = sorted((k, v) for k, v in parse_qsl(parts.query) if k not in DROP)
    return f"{parts.netloc}{path}?{urlencode(query)}"
任务台账用数据库唯一索引来兜底,多进程也安全:
CREATE TABLE seen_task (
  url_key    CHAR(64) PRIMARY KEY,
  created_at DATETIME DEFAULT CURRENT_TIMESTAMP
);

-- 插入成功说明任务被本次认领,可以开始采集
INSERT IGNORE INTO seen_task (url_key) VALUES (%s);
主流程串起来大概长这样:取IP → 发请求 → 报告结果 → 写台账。失败就换个IP重来,同一个任务最多重试两次,超过就记一条待人工复核的记录,别硬刚。
上线之后最容易踩的几个坑
池子空了没人管。脚本跑到凌晨两点,可用列表变成零,程序开始疯狂重试,这时候还在打目标站点,相当于自己暴露。加一个判断:可用IP少于阈值就sleep五分钟,同时发个告警通知。
超时没设。默认超时往往很久,一个坏IP能把整个队列卡住。连接超时设3秒、读取超时设10秒,是个比较合适的起点。
日志只记了成功。出问题的时候你只会看到"没数据",看不到是IP挂了还是页面结构变了。每次请求都记下用的哪个IP、用了多久、返回状态码,事后排查能省一整天。
数据不落盘就先清洗。一口气采了十万条放在内存里,程序一崩全没。边采边写,哪怕先写进一个临时表。
把所有压力压在同一批IP上。有地域要求的任务往往集中拍在某几个城市,这几个城市的IP就成了瓶颈。提前算好每个城市的任务量,按比例配IP,别等跑起来才发现不够用。
不想自己维护这一层,交给现成服务更省事
说白了,代理池这个组件跟业务逻辑没关系,它只是一个中间层。如果你的团队没有精力天天盯存活率,把这一层外包出去是很合理的选择。
以数据采集这类持续轮换的场景来说,动态高级这个方向比较对路:峰值6Mbps、日更200万+IP、时效可选2到360小时。日更量大意味着你不用太担心"池子被用干",时效可选意味着可以按项目节奏配——短期任务选短时效,成本可控;几个月不断跑的项目选长时效,少折腾。
而如果你的任务里有一部分需要保持登录态、维持同一个出口地址,比如自媒体多账号的IP独立防关联,那就用静态高级:长期固定IP、运营商合作资源,6Mbps带宽,一个账号对上一个固定出口,不会今天这个号明天换个地方。
接口层面的适配成本也不高。神龙IP 提供 200+ 城市的精准定位、1000万+ 纯净IP、30ms 极速响应,协议上支持 SOCKS5、L2TP、PPTP、IKEv2、SSTP,数据传输全程加密。机房是自营的,这一点在采集项目里挺关键——IP 段的纯净度直接决定你的可用率。带宽 6-15M 可以按需定制,跑到几十万条一天的规模也不至于卡在带宽上。接入方式就是你上面那个 add() 方法换个地方取数据,代码结构一行都不用改。
常见问题
Q:代理池里的IP多久校验一次比较合适?
别定时全量刷,太浪费。用"被动校验"更划算:每次派发后根据请求结果更新状态,成功就算一次健康确认;同时留一个后台线程,每隔十几分钟抽查一部分长期没被用到的IP,防止池子里藏着大量僵尸。可用率低于七成就该补充新的IP来源了。
Q:去重是不是只做URL就够了?
不够。URL 去重解决的是"同一个链接重复跑",但采集项目里更常见的是"不同链接返回同一内容",比如分页参数越界、筛选条件不同但结果为空。加上内容指纹这一层,能再砍掉百分之十几的无效请求。两道一起用,成本很低,收益很直接。
Q:并发开多大比较稳?
先算:单IP每分钟可承受次数 × 可用IP数 = 理论每分钟请求量,再用这个数反推并发。新手常见做法是直接把并发拉到几十,结果IP被拉黑得比补充还快。宁可慢一点跑稳,也不要快十分钟然后全线阵亡。
Q:任务跑到一半IP全失效了怎么办?
先看看是不是并发和频率的问题,很多时候是把自己打崩的,而不是IP本身不行。如果确认是IP来源质量的问题,换成有稳定日更能力的服务会更省心,切换时只要保证 pick() 和 report() 这两个接口的行为不变,上层业务代码基本不用动。