跑采集脚本的第三天,日志里开始冒红色的 403。前两天还老老实实返回数据的接口,现在连首页都打不开。代码翻来覆去看了三遍,解析逻辑没毛病——问题出在请求这一层,压根不是数据没抓对,是压根没让服务端愿意把数据给你。
这种情况太常见了。刚写爬虫的时候,注意力全在怎么把页面里的字段抠出来,等被封了才回头补功课。要补的东西其实不多,就三块:请求头像不像人、代理IP接得对不对、失败之后怎么处理。下面按这个顺序捋,代码可以直接抄去改。
一、先跑通一次带代理的请求,别急着上框架
新手最容易犯的错,是一上来就搭 Scrapy 工程、写中间件、配管道,结果代理那一步没通,debug 到半夜也找不到原因。先用 requests 把最小闭环跑通,三十行以内解决战斗。
import requests

proxies = {
    "http":  "http://用户名:密码@代理地址:端口",
    "https": "http://用户名:密码@代理地址:端口",
}

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                  "AppleWebKit/537.36 (KHTML, like Gecko) "
                  "Chrome/122.0.0.0 Safari/537.36",
    "Accept-Language": "zh-CN,zh;q=0.9",
}

r = requests.get("http://目标站/列表页",
                 headers=headers,
                 proxies=proxies,
                 timeout=(5, 15))
print(r.status_code, len(r.text))
几个细节值得多说两句。第一,proxies 里 http 和 https 两个键都要写,只写 http 的话,走 https 的站点会直接绕过代理,你以为是代理没生效,其实是根本没走。第二,timeout=(5, 15) 是连接超时和读取超时分开设,连接给 5 秒足够,读取给 15 秒——代理线路偶尔慢,卡在读取上比卡在连接上常见得多。第三,代理带账号密码的写法就是上面那样,用户名和密码直接塞进 URL,requests 会自动做认证,别自己拼 Authorization 头,容易拼错。
如果拿到的代理是 SOCKS5 的,得先装个依赖:pip install "requests[socks]",之后地址写成 socks5://ip:端口 就行。
二、请求头配不好,换多少IP都是白搭
见过不少人,代理买了一大把,被封之后第一反应是"IP质量不行"。打开他的代码一看,User-Agent 写的是 python-requests/2.31.0。这等于在门口贴了张纸,写着"我是脚本"。服务端的风控基本不用动脑子就能把你拦下来。
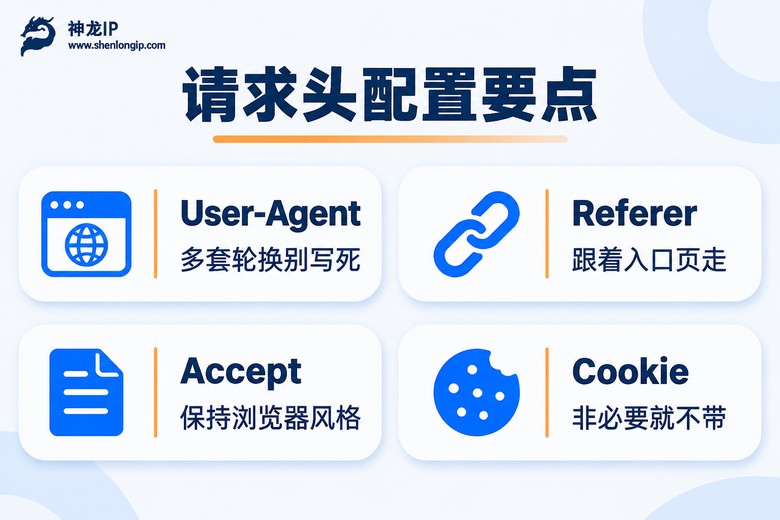
请求头这件事,核心不是"加上就行",而是前后一致、看着自然。具体几条经验:
UA 要有多套,并且跟其他头对得上。准备二三十条真实浏览器 UA,每次请求随机取一条。注意 Chrome 的 UA 配 Chrome 的 Accept,别拿 Windows 的 UA 配 macOS 的 Sec-Ch-Ua-Platform,自相矛盾比没有还显眼。
Referer 最好带上。从列表页点进详情页,Referer 就应该是那个列表页地址。空着不写,一些站点直接判定异常。
Cookie 能不带就不带。很多教程教人往请求头里硬塞 Cookie,其实没必要——你一塞,服务端就能拿它把你这一串请求串起来,一个异常全暴露。除非目标站必须登录,否则保持干净。
别自造请求头。X-Forwarded-For、X-Real-IP 这类手动伪装的字段,稍微像样一点的站点都会校验,加了反而是送分。
import random

UA_POOL = [
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
    "(KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/605.1.15 "
    "(KHTML, like Gecko) Version/17.3 Safari/605.1.15",
    # ... 再放二三十条
]

def build_headers(referer=None):
    h = {
        "User-Agent": random.choice(UA_POOL),
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
        "Connection": "keep-alive",
    }
    if referer:
        h["Referer"] = referer
    return h
三、代理接进来只是开始,会话和轮换得一起管
代理通道打通之后,立刻会遇到第二个问题:什么时候换IP。有人每个请求换一次,结果登录态、翻页参数全乱;有人从头到尾用一个,跑到两千条就没动静了。
比较稳的做法是按批次换。一个 IP 连续跑 20 到 50 个请求,遇到异常再提前换,这样既有会话连续性,又不会把单个 IP 用到死。实现上用 requests.Session() 复用连接,把代理挂到 session 上,换 IP 时重建 session 或者更新 session.proxies。
import requests

class Fetcher:
    def __init__(self, proxy_getter):
        self.get_proxy = proxy_getter
        self.session = None
        self.used = 0
        self.limit = 30          # 每个IP最多用30次
        self._rotate()

    def _rotate(self):
        p = self.get_proxy()      # 从你的代理池里取一个
        self.session = requests.Session()
        self.session.proxies = {"http": p, "https": p}
        self.used = 0

    def get(self, url, headers, referer=None):
        if self.used >= self.limit:
            self._rotate()
        self.used += 1
        return self.session.get(url, headers=headers,
                                timeout=(5, 15), verify=True)
还有一点容易被忽略:代理报错要分类看。ProxyError 说明这个代理本身已经不通了,直接换;ConnectTimeout 可能是目标站慢,也可能是代理线路差,可以再给一次机会;SSLError 出现在某些透明代理上,这时候别急着关掉 verify,换个代理更省事。
四、失败重试:写成 for 循环硬扛是最常见的坑
很多人写重试是这样的:for i in range(5): try... except: continue。跑起来看着能用,实际上问题很大——五次都打在同一个 IP 上,间隔不到零点几秒,本来只是限流,硬生生给刷成了封禁。
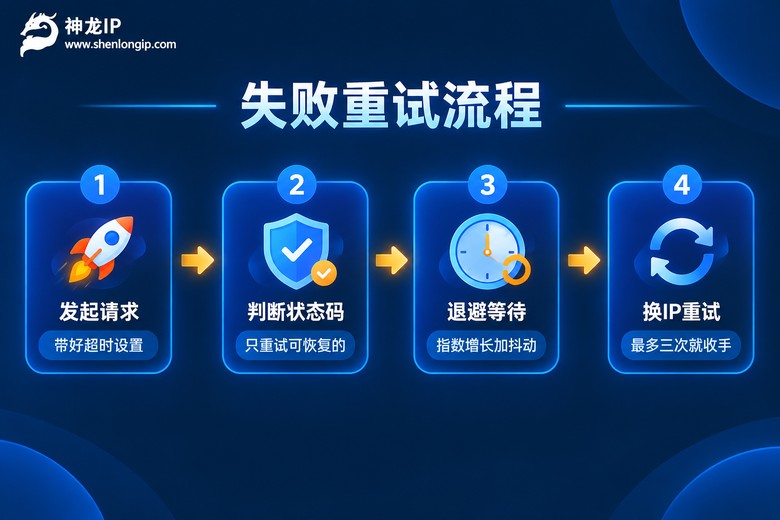
合理的重试机制要看三件事:该不该重试、等多久、换不换IP。
状态码分三类处理。429、500、502、503、504 属于可恢复的,值得重试;403 别死磕,同一个 IP 重试十次也是 403,直接换 IP 再来一次;404、400 这类重试没有意义,记进失败队列就行。
等待时间用指数退避,第一次等 1 秒,第二次 2 秒,第三次 4 秒,再叠一个 0 到 1 秒的随机抖动,避免和你自己的其他线程撞在一起。重试次数给到 3 次足够,超过就放弃这条,记录下来交给下一轮。
import time, random

RETRY_STATUS = {429, 500, 502, 503, 504}

def fetch(fetcher, url, headers, referer=None, max_retry=3):
    for attempt in range(max_retry):
        try:
            r = fetcher.get(url, headers, referer)
            if r.status_code in RETRY_STATUS:
                raise RuntimeError("retry status %s" % r.status_code)
            return r
        except Exception as e:
            wait = (2 ** attempt) + random.uniform(0, 1)
            print("第%d次失败: %s, 等待%.1fs" % (attempt + 1, e, wait))
            time.sleep(wait)
            fetcher._rotate()      # 换一个IP再试,别原地硬扛
    return None
顺带提一句日志。把失败那条的 URL、状态码、用的哪个代理、第几次重试都记下来,跑完之后统计一下:某个代理节点的失败率超过 30%,就应该从池子里剔掉。光靠感觉判断代理好坏,误差大得离谱。
五、代理从哪来:自建还是租,算笔账就清楚
写到这一步,最后一个问题是 IP 资源。自己拉几条宽带、搞几台机器做代理,看着省钱,实际一算:机房带宽按年付,IP 段被标记了还得换,维护成本全落在自己头上。跑量不大还好,一旦每天要发几十万次请求,自建的稳定性基本撑不住。
用服务商省事的地方在于资源池和线路。拿神龙IP来说,200+城市精准定位、1000万+纯净IP、30ms 极速响应,机房是自营的,线路质量自己控得住,不用跟第三方扯皮。协议上支持 SOCKS5、L2TP、SSTP、IKEv2、PPTP 这几种,爬虫最常用的 SOCKS5 直接能接,数据全程加密传输。
套餐怎么挑,取决于你的采集节奏。动态高级套餐的峰值带宽 6Mbps,日更 200 万+ IP,时效 2 到 360 小时可选,适合那种短周期、需要频繁获取新 IP 的任务,比如各地搜索结果比价、商品价格巡检;如果对线路独占和速度更敏感,动态独享给到 10Mbps 峰值,同样是 2 到 360 小时时效,跑起来不那么挤。反过来,如果业务需要长期固定的 IP——比如自媒体多账号的 IP 独立防关联、要维持稳定登录态的采集任务——那就该看静态高级套餐,长期固定 IP、运营商合作资源、6Mbps 带宽,稳定优先。带宽这块还支持 6-15M 定制,量大的时候可以往上加。
常见问题
Q:代理明明接上了,为什么还是返回 403?
A:先分清是被 IP 拦了还是被指纹拦了。把代理关掉用本机 IP 请求同一个页面,如果本机也 403,说明问题在请求头和访问频率,不在代理。如果本机能通、走代理不通,那大概率是这个 IP 段被标记了,换一批试试。另外注意别在同一秒内对同一域名发十几个请求,再干净的 IP 也扛不住。
Q:重试几次比较合适,间隔要多久?
A:3 次是经验值。第一次等 1 秒左右,第二次 2 到 3 秒,第三次 5 秒上下,带上随机抖动。超过三次还失败,说明这条链路本身有问题,继续重试只是浪费时间和 IP 额度,不如记录下来跳到下一条。重试时一定要换 IP,原地重试等于自己给自己加封禁权重。
Q:动态代理和静态代理到底怎么选?
A:看你要不要"记住上一次"。需要保持登录状态、多个账号各自独立环境,选静态固定 IP;只是大范围抓公开列表页、每次请求互不相关,动态更划算,池子大、换得勤。两边都跑过的团队通常会用静态管长会话、动态管高并发,混着来。
Q:采集速度上不去,是代理带宽不够吗?
A:先看瓶颈在哪。单次请求的耗时如果是 200ms 以内,那带宽不是问题,瓶颈在你自己的并发数和目标站的响应速度;如果每次都卡到一两秒,才考虑线路带宽。神龙IP 的带宽是 6-15M 可定制的,真遇到瓶颈可以往上调,但多数时候先把并发管好、把重试逻辑写对,速度自然就上来了。
回过头看,爬虫被封这件事,八成不是运气差,是请求层的三件小事没做扎实。把请求头配得像样、把代理接得规范、把重试写得讲道理,剩下的才是解析和数据清洗的活。代码先跑通,再谈规模。