接口调用这件事,说穿了就是三个动作
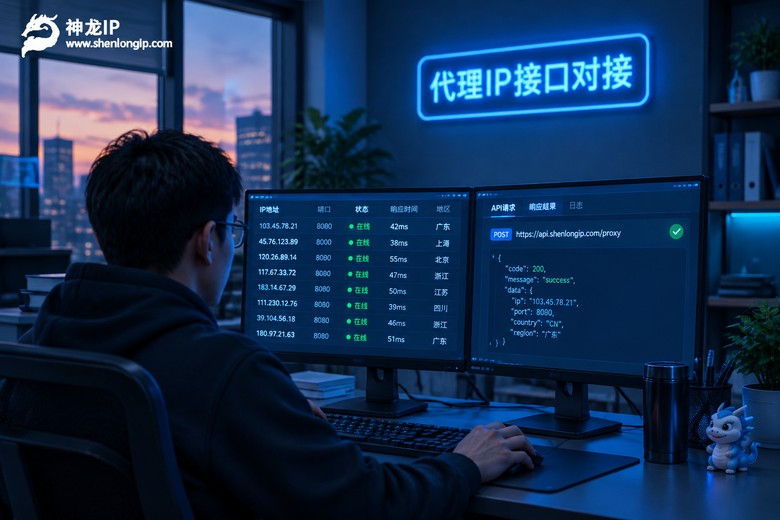
第一次接触代理IP的"接口",不少人会先被吓住,以为要搭一套很重的东西。其实把流程拆开看,你真正要做的只有三件事:证明你是你(鉴权)、把IP要过来(提取)、让请求从这条IP出去(使用)。
服务商给你的是一个带密钥的链接,你用程序去访问它,它就回给你若干条"IP:端口"。拿到之后往代码的 proxies 参数里一填,事情就成了。剩下的都是细节,而细节决定了你的任务能不能稳定跑一整晚。
这篇按真实对接的顺序写,从后台拿信息、选鉴权、拼链接、写代码、查报错,一路走完。中间会给可以直接改改就用的代码,你对着抄就行。
鉴权先定下来,后面少返工
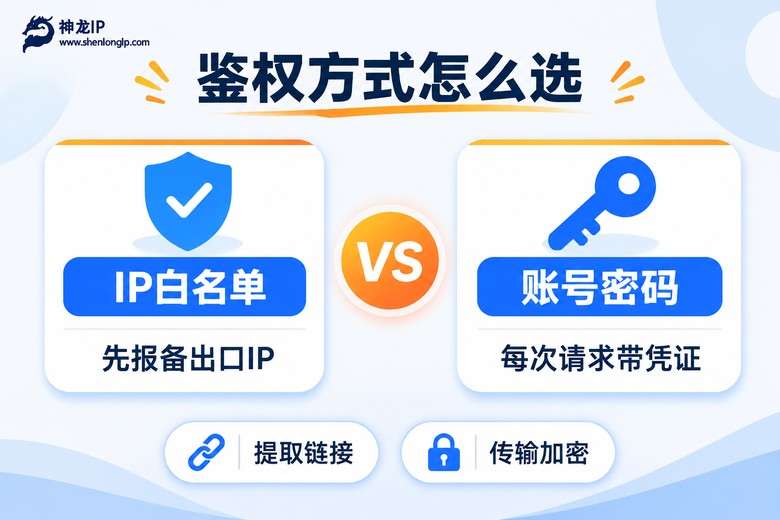
代理IP服务商常见的鉴权就两种:IP白名单和账号密码。选哪个,取决于你的程序跑在哪、出口IP稳不稳定。
IP白名单的逻辑是:你先把运行程序的机器的公网出口IP报备给平台,之后只要是这台机器发来的请求,就不需要再带账号密码。优点是代码里干净,少写一段认证;缺点是换一台机器、或者家里宽带重启后公网IP变了,就得回后台重新报备一次。适合放在固定机房的服务器上。
账号密码的逻辑更直接:每次请求都把用户名密码带上,走到哪都能用。代码稍微多一行,但灵活。本地笔记本调试、云主机临时跑任务,用这个最省心。
有一类新手容易踩的坑:白名单里报备的是公网出口IP,不是内网地址。很多人在后台填了个 192.168.x.x,然后一直连不上,回头查了半小时。报备前先在机器上访问任意一个查询出口IP的页面,看到什么就填什么。
账号密码鉴权:代码长什么样
先说这种,因为它最通用。后台一般会给出四项信息:接入地址、端口、账号、密码。你把它们拼成 用户名:密码@地址:端口 的形式,塞给 requests 就行。
import requests

proxy_host = "后台给的接入地址"
proxy_port = "后台给的端口"
username   = "你的账号"
password   = "你的密码"

# http 协议写法
proxy_url = f"http://{username}:{password}@{proxy_host}:{proxy_port}"

proxies = {
    "http":  proxy_url,
    "https": proxy_url,
}

target = "http://你要访问的目标页面"

resp = requests.get(target, proxies=proxies, timeout=10)
print(resp.status_code)
print(resp.text[:200])
如果你走的是 SOCKS5,把前缀换掉即可,注意先装 requests[socks]:
proxy_url = f"socks5://{username}:{password}@{proxy_host}:{proxy_port}"
一个小细节:密码里如果带 @ 或者 # 这种符号,一定要做 URL 编码,否则整段字符串会被拆错位置,最后表现成 407 认证失败,非常迷惑。用 urllib.parse.quote(password, safe="") 处理一下最稳。
神龙IP 这边支持 IKEv2、PPTP、L2TP、SSTP、SOCKS5 几种协议,数据传输全程加密。选哪个不用纠结太多:纯程序调用优先 SOCKS5,兼容性好;要走系统级连接就按后台文档对应配置。
白名单鉴权:少写一半代码
报备好出口IP之后,代码里就不用带账密了:
proxy_url = f"http://{proxy_host}:{proxy_port}"

proxies = {"http": proxy_url, "https": proxy_url}
resp = requests.get(target, proxies=proxies, timeout=10)
就这么短。但记得给 session 加个统一的超时和重试,别让某一条慢连接把整个线程卡死。我一般的做法是 timeout=(5, 15),连接 5 秒、读取 15 秒,超过就丢弃这条IP换下一条。
从提取到跑通,完整对接流程
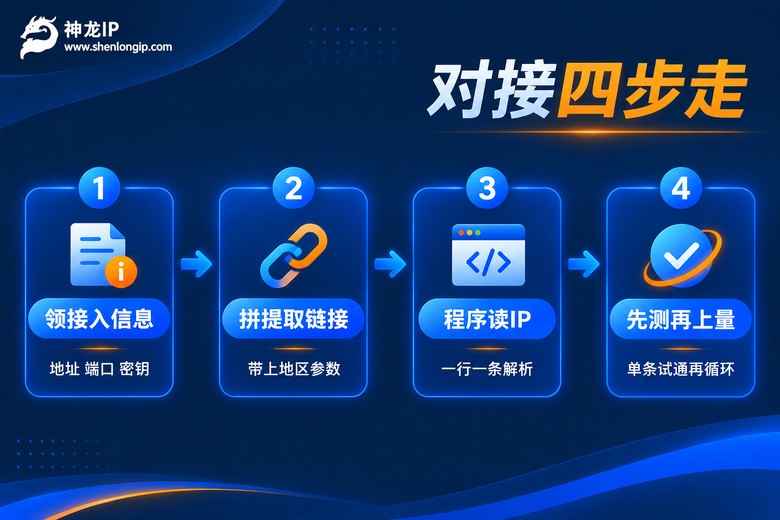
下面这四步,是我每次接新项目都会重新走一遍的顺序,你可以直接照着做。
第一步,把接入信息抄全。后台里有接入地址、端口、账号密码或者白名单设置,还有一条提取链接。这条链接里已经带了你的密钥和一堆参数,别手改。抄到本地一个 .env 文件里,别硬编码进代码。
第二步,读懂提取链接里的参数。常见的有:提取数量(一次要几条)、地区(要哪个城市的IP)、时效(这条IP能用多久)、返回格式(纯文本还是 JSON)。神龙IP 支持 200+ 城市精准定位,你要做各地搜索排名测试,就把地区参数填到对应城市,别全省默认。
第三步,程序读回来解析。纯文本格式一般是一行一条 IP:端口,按行切成列表就行:
import requests

extract_api = "后台复制出来的提取链接"

text = requests.get(extract_api, timeout=8).text
ip_list = [line.strip() for line in text.splitlines() if line.strip()]

print("本次拿到", len(ip_list), "条")
for item in ip_list[:3]:
    print(item)
第四步,先测再上量。拿第一条IP,单独发一个请求,确认返回正常、出口IP确实变了,再把循环打开。这一步能省掉后面 80% 的排查时间。
真正跑起来之后,这几处最容易出问题
提取太勤。有人写了个 while True 循环里每次都去拉一次链接,跑两分钟就被限流。正确做法是一次取够、缓存复用:拿 20 条回来放进队列,用完再取下一批。神龙IP 动态高级套餐日更 200 万+ IP,池子够大,但你的请求频率还是得按后台的说明来,别踩限流线。
时效没算。每条IP是有寿命的,2 到 360 小时不等。如果你的任务跑一整夜,要记录每条IP的拿取时间,超过时效就主动淘汰,别等它报错。动态高级和动态独享都是这个时效区间,做长任务时把过期逻辑写上,稳定性会明显好一截。
并发开太大。带宽是 6-15M 可定制的,不是无限。开 50 个线程去抢同一条 6Mbps 的通道,谁都跑不快。一般先 5-10 并发试,看响应时间和成功率,再逐步往上加,找到那个拐点。
只用一个地区。如果你要做各地的营销推广效果核对,一直用同一个城市的IP,看到的结果其实是偏的。把地区参数按目标城市轮换,结论才站得住。
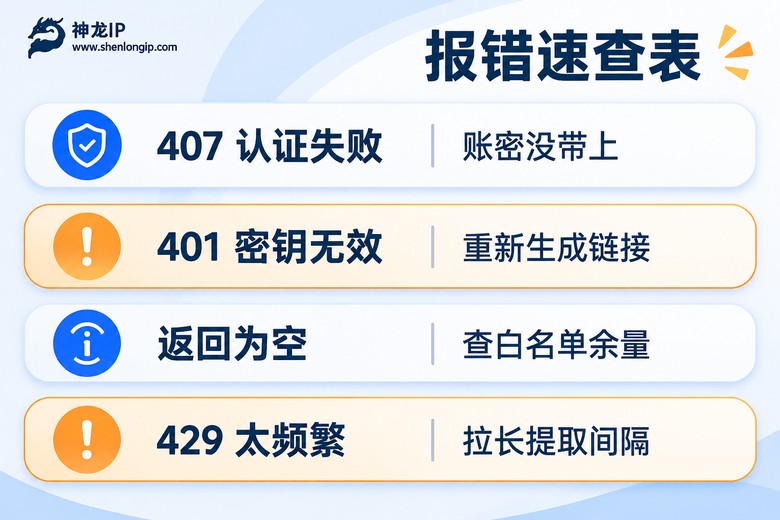
报错别慌,对着这张表查
| 现象 / 返回 | 大概率原因 | 怎么处理 |
|---|---|---|
| 407 Proxy Authentication Required | 账号密码没带上,或密码含特殊字符被截断 | 检查拼接格式,对密码做 URL 编码 |
| 401 / 链接提示密钥无效 | 提取链接被重置或复制时少了一段 | 回后台重新生成一条,整段复制 |
| 提取返回空白 | 白名单没报备,或套餐余量不足 | 先查本机出口IP是否已报备,再看余量 |
| 连接一直超时,30 秒无响应 | 本地网络限制,或端口不通 | 换一个协议端口再试,SOCKS5 优先 |
| 429 / 提示请求过快 | 提取间隔太短 | 拉长间隔,改成缓存复用IP |
| 能连上但目标页返回异常 | IP已被目标站点限流 | 换一条IP,降低单IP请求密度 |
套餐怎么配你的调用方式
接口写法定了之后,剩下就是选型。这里只讲匹配关系,你对着自己的场景挑就行。
如果你的程序是按需提取、用完就扔那种——比如数据采集、各地搜索排名测试——看动态高级套餐:6Mbps 峰值、日更 200 万+ IP、2-360 小时时效,池子大、换得勤,接口调用时一次性拿一批回来轮着用,节奏刚好。
如果对稳定性和独占性要求更高,比如服务器压力测试要持续跑、或者自媒体多账号需要IP彼此独立不关联,那动态独享更合适,10Mbps 峰值,同样 2-360 小时时效,通道是你自己的,不会跟别人挤。
还有一种情况是长期固定IP,比如要给某个后台做长期登录态维护、或者需要运营商合作资源那种稳定出口,那就选静态高级,6Mbps,IP 长期不变,接口上基本取一次就够用很久。
顺带提一句基础设施:神龙IP 是自营机房,1000 万+ 纯净 IP,响应能压到 30ms 级别。这些数字在你写代码时的实际意义是——你可以把超时阈值设得比较紧,不用为了等一条慢连接留出十几秒的缓冲。
常见问题
Q:提取链接能不能直接写在代码里?
能跑,但不建议。链接里带着你的密钥,一旦代码进了仓库或者被人看到,等于把账号交出去。放到环境变量或者配置文件里,再加个 .gitignore,成本很低。
Q:一次提取多少条比较合适?
看你的并发和单条IP的时效。经验值是并发数的 2 到 3 倍,比如 10 并发就一次拿 20-30 条,用完再取。一次拉太多用不完,等轮到时候已经过期了,反而浪费。
Q:白名单和账号密码能同时用吗?
一般设好一种就够了,具体以后台说明为准。如果你在机房用白名单、本地调试用账密,两种方式分别配置、互不干扰就行。
Q:接口调通了,但成功率一直上不去怎么办?
先分清楚是IP的问题还是目标站点的问题。做法很简单:拿一条IP连续请求十次,看失败是集中在某几条IP上,还是均匀分布。集中就是IP质量问题,换一批;均匀分布多半是你的请求频率或并发打太高,先降下来再看。
Q:换地区需要改代码吗?
不用,改提取链接里的地区参数就行。把参数提到配置文件里,按城市列表轮着读,代码逻辑一行都不用动。