上个月有个做电商的朋友找我帮忙:他想每天早上自动盯一遍几十个竞品链接的价格变化。脚本本身不难,百来行代码的事。结果跑了两小时不到,对方页面开始返回验证码,再后来干脆连不上。排查了半天,问题不在代码,而在他全程用同一个IP发请求——网站一看,同一个地址几分钟里访问了几百次,不拦你拦谁。
做数据采集的人几乎都栽过这个跟头。今天这篇文章,就把2026年还在用的稳妥做法完整捋一遍:网站是怎么发现你的、动态代理IP在其中起什么作用、脚本怎么写,以及最后怎么选套餐。
网站是怎么发现你在采集的
很多人以为网站有专门的"反采集雷达",其实大部分判断逻辑简单得出乎意料,主要看四件事:
一是访问频率。正常人逛页面,看几秒点一下,一分钟撑死十几个请求。脚本不一样,循环一跑,每秒好几个请求砸过去,特征太明显了。
二是IP的重复度。同一个IP地址,短时间内请求了成百上千个页面,这基本就等于举手报告"我是脚本"。
三是请求头的样子。用默认设置发出去的请求,身份标识往往一眼就能认出来,和正常浏览器差距很大。
四是行为轨迹。真人会滚动、会停留、会点进详情页再退出来;脚本通常是直线型地挨个抓,规律得像钟表。
这四条里,频率和IP重复度是最容易触发限制的,也是动态代理IP直接能解决的部分。
动态代理IP到底解决了什么
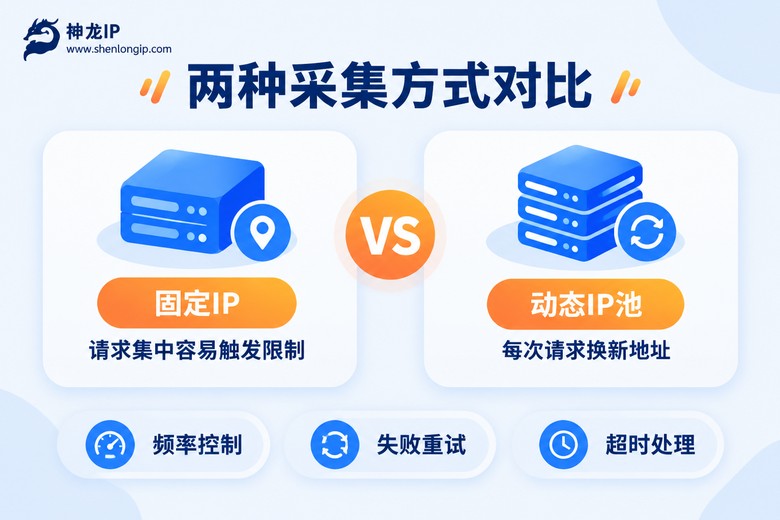
原理说穿了很简单:你在本机和目标网站之间加了一层中转。请求先发到代理服务器,由它代替你去访问,再把结果带回来。目标网站看到的是代理服务器的地址,而不是你的真实IP。
动态代理的特殊之处在于,这个中转地址不是固定的——每次请求都可以从IP池里拿一个新的地址。对网站来说,访问者变成了成百上千个"不同的普通人",每个地址的请求量都不高,自然不容易触发限制。
那动态和静态怎么分?静态IP是长期固定的一个地址,适合需要"身份稳定"的场景;动态IP则是短时效、大量更替,天然适合采集这种需要分散请求的任务。拿神龙IP的动态高级套餐来说,日更200万以上的IP量,意味着你几乎不用担心池子被用旧,时效还能在2到360小时之间按需设置。
动手写一个带IP轮换的采集脚本
下面用Python写一个最小可用的例子,思路是:准备一组代理地址,每次请求随机取一个,失败就换一个再试。
import requests
import random
import time

# 代理地址从服务商后台复制,格式一般是 用户名:密码@ip:端口
PROXIES = [
    "http://user:pass@113.xx.xx.1:8000",
    "http://user:pass@113.xx.xx.2:8000",
    "http://user:pass@113.xx.xx.3:8000",
]

HEADERS = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
}

def fetch(url):
    for attempt in range(3):
        pick = random.choice(PROXIES)
        try:
            resp = requests.get(
                url,
                proxies={"http": pick, "https": pick},
                headers=HEADERS,
                timeout=10
            )
            if resp.status_code == 200:
                return resp.text
        except Exception:
            pass
        time.sleep(random.uniform(2, 5))  # 失败后歇一下,换个IP再试
    return None

url = "https://www.目标网站.com/list?page=1"
html = fetch(url)
print(html[:500] if html else "这次没抓到,稍后再跑")
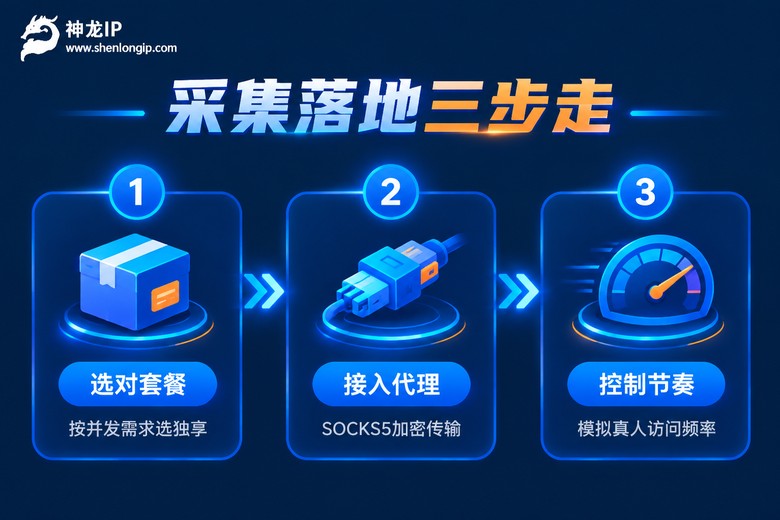
几个细节值得注意。如果服务商给的是SOCKS5协议的地址,把开头的http://换成socks5://,另外装一下支持库:pip install requests[socks]。神龙IP支持SOCKS5等多种接入方式,数据传输全程加密,接入这一步基本照着后台文档复制粘贴就行。
还有一点新手常忽略:超时一定要设。timeout=10这行别删,否则碰到一个响应慢的代理,整个任务就卡死在那里了。
比代码更重要的几件小事
脚本跑通只是及格线,想让它稳定跑上几周甚至几个月,下面这几件事才是拉开差距的地方。
把节奏放慢。每次请求之间随机停3到8秒,别用固定间隔——固定间隔本身也是一种规律。宁可多跑半小时,也别为了快几分钟把任务搭进去。
失败就换,别硬磕。某个IP连续失败两次,直接从池子里换下一个,把失败的记下来。好的IP池会自动淘汰质量差的地址,这也是为什么自建免费代理池的效果往往不如付费的稳定。
把日志写下来。每次请求的时间、用了哪个IP、返回状态码,都追加到日志文件里。出了问题翻日志,十分钟就能定位是IP的问题还是页面结构变了。
挑对时段。目标网站流量高峰期(比如晚上八点到十一点)服务器本来就忙,你的请求更容易被重点照顾。凌晨时段跑任务,通常顺畅得多。
地区要对得上。如果你采集的是带地区属性的数据,比如某城市的本地信息,代理IP的地区也要选一致。神龙IP支持200多个城市的精准定位,需要哪个城市的IP就取哪个,数据口径不会串。
套餐怎么选:一张表看明白
以神龙IP的两种动态套餐为例,差别主要在带宽和独享属性上:
| 对比项 | 动态高级 | 动态独享 |
|---|---|---|
| 峰值带宽 | 6Mbps | 10Mbps |
| IP时效 | 2-360小时可选 | 2-360小时可选 |
| 使用方式 | 共享池,日更200万+ IP | 独享通道,不与他人共用 |
| 适合场景 | 日常规模的价格、内容采集 | 并发高、对稳定性要求高的任务 |
简单说:每天抓几千个页面、对速度要求不苛刻,动态高级够用,性价比高;如果是多任务并行、单次数据量大,动态独享的10Mbps峰值带宽和独享属性会更省心。拿不准的话,先按小规格跑两天,看日志里的成功率和耗时,再决定要不要升级。
常见问题
Q: 动态IP和静态IP,采数据该用哪个?
绝大多数采集任务选动态。因为采集的核心诉求是"每个地址的请求量都不高",动态IP天然符合。只有当你需要长时间维持同一个身份访问(比如持续监控某个需要登录状态的后台)时,才考虑静态高级这类长期固定IP。
Q: 一个IP用多久换一次比较合适?
没有标准答案,看目标网站的容忍度。保守做法是每个IP只用几分钟到几十分钟,或者按请求量算,一个IP跑一两百个请求就换。神龙IP的时效可以设2到360小时,建议从短时效开始试,逐步放宽,观察返回状态码的变化。
Q: 采集时老是弹验证码,是IP质量的问题吗?
不一定,先排查三件事:请求头是不是太简陋、频率是不是太快、IP是不是用了太久的旧地址。如果这三点都调整过还是频繁出现,那大概率是IP池质量的问题,换一家纯净度高的服务商(比如自营机房的神龙IP)通常会有明显改善。
Q: 不太会写代码,也能用动态代理IP吗?
可以。市面上很多采集工具都支持填入代理地址,你在服务商后台复制好IP和端口,粘进工具的代理设置里就能用。先把单机单IP的流程跑通,再逐步加上换IP的逻辑,不用一开始就啃代码。