先把“换IP”这件事从手上拿开
凌晨一点半,脚本跑到第七百多条请求时突然一片报错,清一色连接超时。你打开代理列表一看,二十条IP里十九条已经没反应,剩下那条还在硬撑。手动一条条复制、粘贴、试通,等你弄完,天都快亮了。
这种活儿本来就不该人来干。一个能自动跑起来的动态IP代理软件,核心就三件事:什么时候换、换到不能用的怎么发现、换的过程中别把正在跑的任务弄断。听着简单,真调起来参数没配对,比手动还折磨人。
下面按我自己踩过的坑,把这三块拆开讲,能直接抄的配置我也贴出来。
任务调度:把“什么时候换IP”写成一张计划表
先说调度。很多人以为调度就是“每隔N秒换一次”,这其实是最粗糙的做法。请求有快有慢,同一条IP在凌晨能撑十分钟,在晚上高峰可能两分钟就被目标站限速。比较稳的做法是几个触发条件同时挂着,谁先满足听谁的。
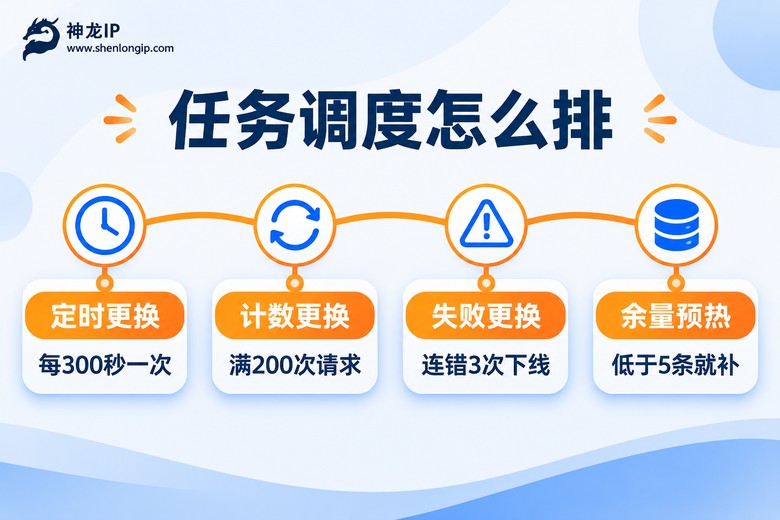
我常用的四类触发:定时换,兜底用;跑满多少次请求就换;连续失败几次直接判死;池子里可用余量见底时提前补货。四个条件互不冲突,写进配置大概长这样:
{
  "pool_size": 20,
  "schedule": {
    "rotate_every_seconds": 300,
    "rotate_on_requests": 200,
    "rotate_on_failures": 3,
    "min_idle_in_pool": 5
  },
  "region": ["上海", "杭州", "成都", "武汉"]
}这几个数字不是随手填的。pool_size 给到20是个比较舒服的值——太少,几条同时没反应就断粮;太多,每条IP都用不满时效,纯浪费。rotate_every_seconds 定在300秒,是因为大部分短时效IP的最小可用时长就在这个量级,再短等于白拿资源。
还有一个容易忽略的细节:预热要早一步。别等池子空了才去要IP,那时候请求已经在排队了。我习惯把下限设在5条,掉到5条就补,补的时候主任务完全无感。
失效检测:IP挂掉不可怕,晚发现才可怕
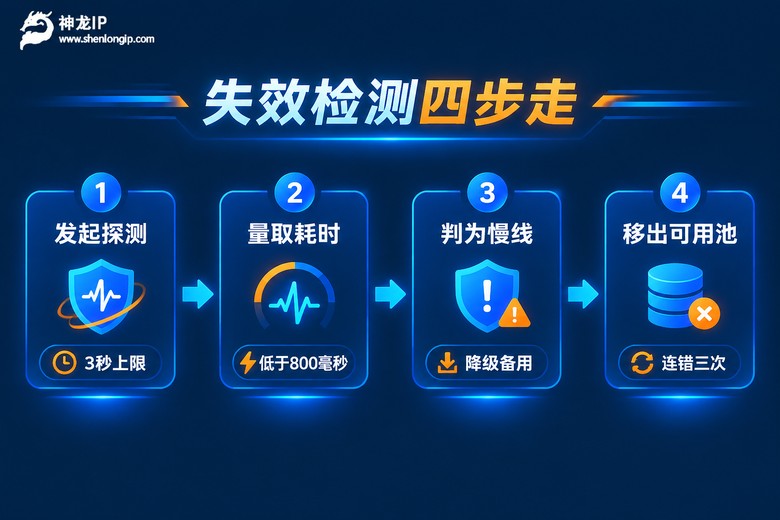
一条IP从“能用”到“不能用”,中间是有过程的。先是响应变慢,从80毫秒涨到600毫秒,然后开始零星超时,最后彻底连不上。如果只靠“报错了才算挂”,你会在最慢的那个阶段白扔掉一大堆请求。
所以我一般在软件里单独挂一个检测线程,专门干一件事:隔一段时间,拿池子里的IP去请求一个小页面,看它多久回来。探测目标别选首页,太大;用一个几KB的静态页或者接口,几秒钟就能出结果。
def check(ip, probe_url, timeout=3, slow_line=800):
    start = time.time()
    try:
        resp = session.get(probe_url, proxies=ip, timeout=timeout)
        cost_ms = (time.time() - start) * 1000
        if resp.status_code != 200:
            return "bad"
        if cost_ms > slow_line:
            return "slow"      # 先降级,不立刻扔掉
        return "ok"
    except Exception:
return "bad"注意这里返回的是三种状态,不是两种。“slow”的IP不马上丢,只是从主力池挪到备用池,重活不给它,轻活还能用。多了这个中间态,一个池子能省下三成左右的IP。
检测频率也别死磕。池子20条,每条超时3秒,一轮最多60秒跑完。我一般设成每60秒全量检测一次,同时给每条IP记一个“连续失败次数”,累计到3次才真正下线。单次抖动就判死,误杀率高得离谱。
连接保持:别让跑了半小时的任务死在最后一步
前两块做好,池子是干净的。但干净的池子照样会让任务断——因为断的原因往往不是IP,是连接本身。长任务跑到第二十分钟,连接被中间设备悄悄回收了,你的程序还傻等着,一直等到超时才反应过来。
这里要设三样东西。
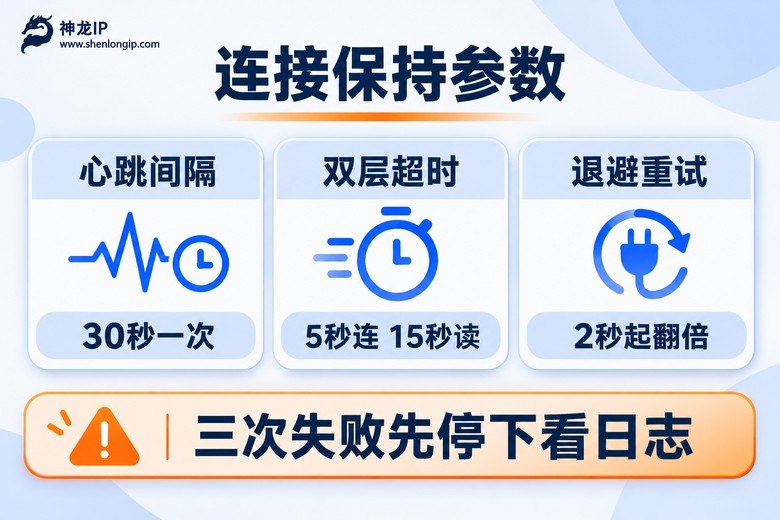
心跳间隔。30秒发一次轻量请求或者保活包,让链路始终是“活的”。间隔太长,比如5分钟,中间设备早就把空闲连接清掉了;太短又白白浪费请求额度。30到60秒之间比较稳。
超时时间。分两层写:连接超时给5秒,读取超时给15秒。混成一个10秒看着省事,真排查的时候你根本分不清是连不上,还是连上了没数据回来。
退避重试。失败之后别立刻重试,第一次等2秒,第二次等4秒,第三次等8秒,翻倍往上走。目标站正在限速的时候,你越急它越不理你。
def fetch(url, pool, retries=3):
    for i in range(retries):
        ip = pool.get()
        try:
            return session.get(url, proxies=ip,
                               timeout=(5, 15),
                               headers={"Connection": "keep-alive"})
        except (ProxyError, Timeout):
            pool.mark_bad(ip)
            time.sleep(2 ** i)   # 2s, 4s, 8s
    raise RuntimeError("三次都失败,先停下来看日志")
最后那句 raise 是特意写的。很多脚本失败之后默默重试到天亮,日志里一片空白,第二天根本不知道出过什么事。连续三次失败就该停,停下来看一眼,是IP的问题,还是目标站改了规则。
参数放一块看,调起来心里有数
散着调容易顾此失彼,我把自己常用的一套值整理成表,你可以先照抄,跑一天再按失败率微调。
| 参数 | 建议值 | 为什么这么设 |
|---|---|---|
| 池子大小 | 20-50 条 | 低于20条,几条同时没反应就断供 |
| 定时更换 | 300 秒 | 贴合短时效IP的最小可用时长 |
| 计数更换 | 200 次请求 | 避免单条IP被目标站限速 |
| 余量下限 | 5 条 | 提前补货,主任务无感 |
| 检测超时 | 3 秒 | 超过3秒的IP已经算慢的 |
| 慢线阈值 | 800 毫秒 | 高于这个值降级到备用池 |
| 连续失败上限 | 3 次 | 单次抖动不判死,减少误杀 |
| 心跳间隔 | 30 秒 | 防止空闲连接被中间设备回收 |
| 退避倍数 | 2 倍 | 2s / 4s / 8s,避开限速高峰 |
调优的顺序也有讲究。先看失败率,再看平均耗时,最后才动池子大小。反过来调,你会发现改了半天,问题其实是出在探测地址本身。
池子的上游要稳,前面写的逻辑才有意义
上面所有的调度和检测,都建立在一个前提上——你拿IP的那个源头得靠谱。源头隔三差五断供,前面写的降级、预热、退避全白搭。
我自己在自动化任务里常用的是神龙IP,几个点比较贴合这种跑法。它是自营机房,200+城市精准定位,做各地搜索结果对比这类活儿,指定城市取IP很省事;响应普遍在30ms这一档,检测线程跑起来不会把整轮时间拖长。带宽6-15M可定制,拿来跑数据采集这种偏重吞吐的任务够用。协议支持 IKEv2、PPTP、L2TP、SSTP、SOCKS5,数据传输全程加密,代码里接 SOCKS5 就行。
套餐挑哪种,看任务时长。短时任务用动态高级,6Mbps峰值,日更200万+IP,时效2-360小时随便选,跟上面那套300秒调度正好搭;如果对线路稳定性要求更高,动态独享是10Mbps峰值,同样2-360小时时效,不会跟别人挤一条线。要是做多账号的IP独立防关联,那种需要长期固定身份的场景,就用静态高级,运营商合作资源,长期固定IP,6Mbps,IP不换,登录状态也不会掉。
常见问题
Q:换IP的频率到底多高合适?
看目标站的反应,别看心情。起步就用300秒或者200次请求二选一,跑满一天统计失败率:超过5%就调密一点,低于1%就放宽。一上来就60秒一次的,多半是在浪费时效。
Q:检测一轮全部判定失败,是不是IP全挂了?
大概率不是。先确认探测地址本身通不通,很多时候是探测目标挂了或者被限速,把整轮检测带崩。换一个几KB的静态页再跑一轮,能排除八成误判。真全挂了,那就是上游的问题,该看服务商了。
Q:长任务跑到一半断线,先改哪个参数?
先看心跳。30秒一次基本能解决大部分中途断连。还断,就查读取超时,15秒对下载类任务可能偏短,给到30秒试试。最后才怀疑IP,因为单条IP失效通常只影响一两个请求,不会整段断掉。
Q:时效选2小时还是24小时?
任务跑得完就选短的,短时效的IP更干净。超过2小时的长任务,选24小时,或者直接用静态高级的固定IP。中途换IP最容易把会话弄丢,反而得不偿失。