先分清楚是谁拖慢了你
下午三点,做本地生活推广的老周在挨个核对各地搜索结果,页面转了快十秒才出来。他第一反应是"这家代理不行",于是不断获取新的 IP,结果还是卡。最后查出来的原因是两件事:电脑上同时挂着网盘同步,出口节点的位置又在两千公里之外。
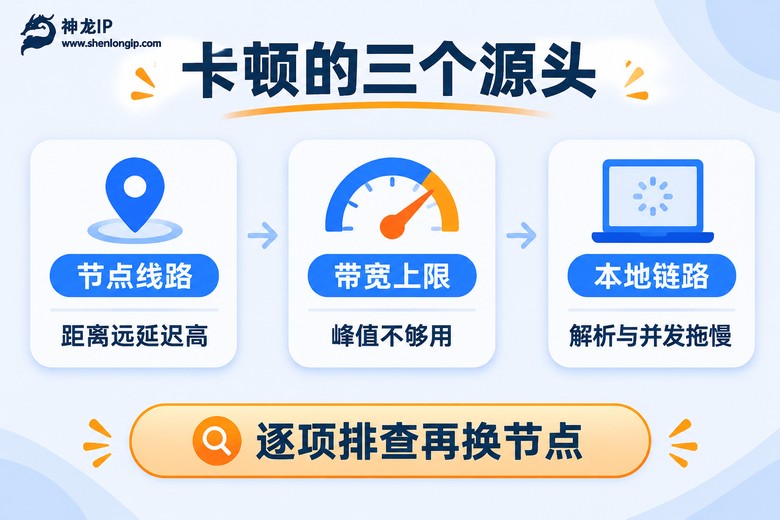
类似的情况每周都在发生。代理IP用起来卡,很少是单一原因,绝大多数时候是三个环节里至少有一个拖后腿——出口节点离目标站太远、服务商给的带宽被别人分掉、或者你自己的本地链路本来就不干净。排错顺序应该从外到内,而不是一上来就疯狂试新 IP。
有个两分钟能做完的判断:同一时刻,带代理和不带代理各访问一次同一个页面,分别记下首字节时间。差距在 200 毫秒以内,问题大概率在本地;差距拉到一秒以上,问题在节点或代理链路。再挑三个不同地区的节点各测一遍,都慢说明是服务商侧,只有一个慢那就是那一个节点的事。
TARGET="https://你的目标站"

# 连测三次,看连接耗时和总耗时的波动
for i in 1 2 3; do
  curl -o /dev/null -s \
    -w "连接 %{time_connect}s | 首字节 %{time_starttransfer}s | 总计 %{time_total}s\n" \
    --proxy socks5h://用户名:密码@节点地址:端口 "$TARGET"
done
三次结果如果相差很大,比如一次 0.8 秒、两次 4 秒,说明线路在抖,不是你脚本写错了;三次都很稳但都慢,那是带宽或者物理距离的事,往下看。
节点不是随便挑一个就行
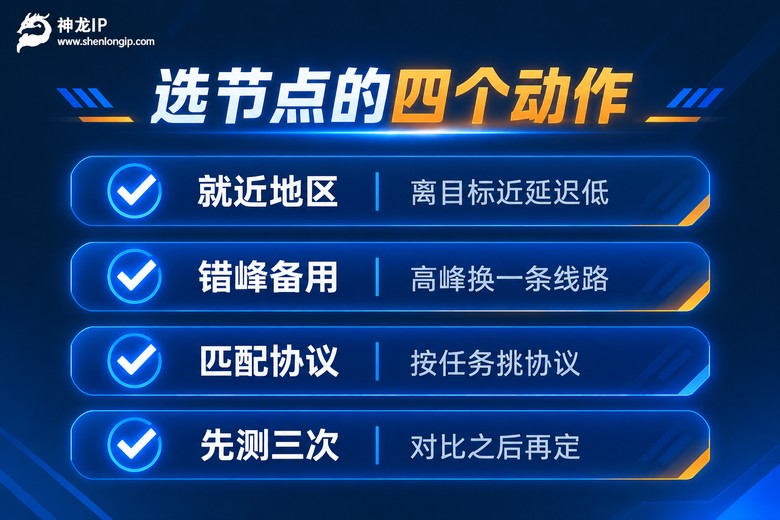
节点选择的第一原则是就近。你要采的目标站在哪个区域,就找那个区域或者相邻区域的节点。物理距离每多一千公里,往返延迟通常多 10 到 20 毫秒,单次请求看不出来,跑几千次就是好几分钟的差距。神龙IP 提供 200+ 城市的精准定位,选城市的时候别只挑"离我近",要挑"离目标近"。
第二原则是错峰。同一个出口上如果挤了太多人,请求就得排队,表现出来就是时快时慢。白天顺得不行,一到晚上八点就卡,基本是这么回事。要么避开高峰时段跑,要么直接换独享类产品,别在共享线路上硬扛。
第三是协议要跟任务匹配。同一个节点,换协议之后速度能差出一截,这不是玄学,是握手开销和封装方式不一样。
| 协议 | 开销 | 实际感受 | 适合的任务 |
|---|---|---|---|
| SOCKS5 | 低 | 握手轻,短连接最省时间 | 数据采集、IP轮换、多账号独立防关联 |
| IKEv2 | 中 | 断线重连快,挂久了不掉 | 长时间的排名监测与检查 |
| L2TP | 中 | 兼容性好,路由器能直接拨 | 设备较多的小团队 |
| SSTP | 中 | 传输加密完整,稳定性可以 | 对加密有要求的办公环境 |
| PPTP | 低 | 配置最省事 | 老设备临时用一下 |
顺手提一句,跑脚本的话地址写成 socks5h 而不是 socks5,前者把域名解析也交给节点去做,能省掉一次本地查询,几百毫秒有时候就是这么挤出来的。
带宽要对得上你的并发量
很多人挑套餐只看"多少个 IP",不看峰值带宽,结果 IP 试了一堆,速度还是上不去。带宽才决定同一时间你能跑多少活。
算一笔简单的账:假设一页内容大约 1MB,你想同时开 5 个任务、每个 5 秒跑完。同一秒要传输的数据是 5MB ÷ 5 秒 = 1MB/s,换算成带宽差不多 8Mbps。这种情况下 6Mbps 的峰值就成了瓶颈,页面会被拉长,选 10Mbps 峰值那档更稳。
神龙IP 的线路带宽 6-15M 可定制,配合 30ms 级别的响应,多数采集和监测任务够用。产品上分得比较清楚:
| 套餐 | 峰值带宽 | IP 时效 | 适合谁 |
|---|---|---|---|
| 动态高级 | 6Mbps | 2-360 小时,日更 200 万+ | 轻量采集、各地排名抽查 |
| 动态独享 | 10Mbps | 2-360 小时 | 并发偏高、要求稳定 |
| 静态高级 | 6Mbps | 长期固定,运营商合作资源 | 需要固定出口的长期任务 |
| 充值套餐 | 按需使用 | 按量计费 | 任务不规律的临时需求 |
还有一个容易被忽略的点:并发不是越大越快。开 50 个线程打同一个目标站,对方限速、你这边排队,整体反而比 8 个线程更慢。先按带宽倒推一个并发上限,超了就减。
本地链路:最便宜也最常被忘掉的一段
出口再快,你本机到路由器那一段卡着也是白搭。这段不花钱,动手调一调就有变化。
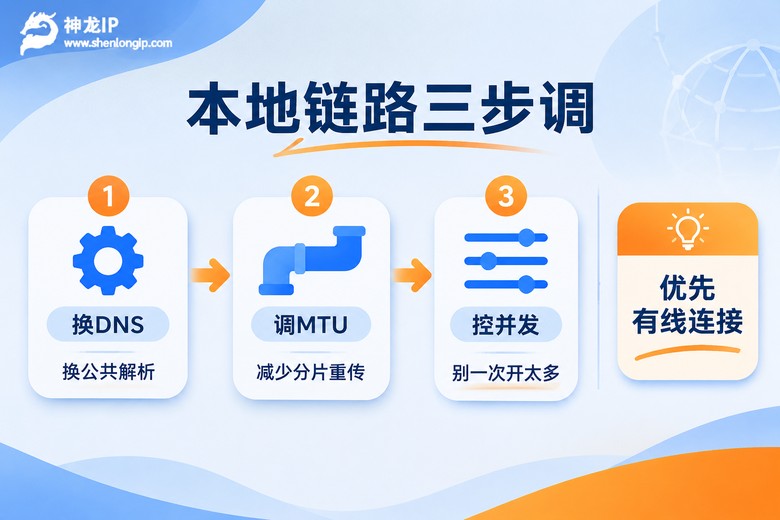
先把无线换成有线。同一个位置,从 Wi-Fi 到网线,延迟波动能从 ±60ms 收窄到 ±10ms 以内,丢包肉眼可见地降。接着再做几件事:把网盘、系统更新、浏览器后台标签这些偷带宽的关掉;本地 DNS 换成响应稳定的公共解析;MTU 如果设得偏大,遇到分片会触发重传,往小调一档试试;跑量大的任务时把连接复用打开,别每次请求都重新握手。
import requests
from concurrent.futures import ThreadPoolExecutor

s = requests.Session()          # 复用连接,省掉重复握手
s.proxies = {
    "http":  "socks5h://用户名:密码@节点地址:端口",
    "https": "socks5h://用户名:密码@节点地址:端口",
}
s.headers.update({"Connection": "keep-alive"})

def fetch(url):
    r = s.get(url, timeout=(5, 20))   # 连接 5 秒、读取 20 秒,别设成无限
    return len(r.content)

urls = ["https://你的目标站/page-1", "https://你的目标站/page-2"]

with ThreadPoolExecutor(max_workers=8) as pool:   # 并发按带宽倒推,别一上来就 50
    for size in pool.map(fetch, urls):
        print(size)
超时也别设成无限。很多"卡住不动"其实是某个请求挂在那儿,把整条队列堵死了,设了超时至少能跳过它继续往下跑。
照这个顺序调,一遍就能定位
把上面这些串成一套动作,下次再卡,按顺序走一遍就行。
第一步,清掉本地干扰(后台同步、无线改有线),测一次基线。第二步,用同一个节点连测三次,看波动大不大,波动大就换线路。第三步,换三个不同地区的节点做对比,判断是节点个例还是服务商侧的问题。第四步,按任务挑协议,短连接优先 SOCKS5。第五步,用实测吞吐倒推并发数,把峰值带宽用满但不超。第六步,还不行再考虑升带宽档位或者换独享。
大部分人走到第三、第四步就解决了。真到第五步还卡,那说明你的任务量确实超过了当前规格,该升级就升级,别在 6Mbps 的小水管上硬塞十路并发。
为什么这类问题我更愿意交给神龙IP
排查做多了会发现,很多坑本质上是资源不透明造成的——你不知道这个出口上还挤着多少人,也不知道带宽峰值到底给没给够。神龙IP 是自营机房,200+ 城市精准定位、1000万+ 纯净IP,带宽 6-15M 可定制,这几个数字在调优时是能对上的:选城市的时候真能选到目标所在的那座城,而不是"某个大区随机"。
产品线上,如果你做的是营销推广和各地搜索排名测试,需要经常换地区、单次请求也不重,动态高级那档(6Mbps 峰值、日更 200 万+、2-360 小时时效)就够用;如果是数据采集、服务器性能与压力测试这类并发偏高的活,直接上动态独享,10Mbps 峰值一个人用,不用和别人抢;要是任务必须挂在一个固定出口上长期跑,那就静态高级,运营商合作资源、长期固定 IP。IKEv2、PPTP、L2TP、SSTP、SOCKS5 都支持,数据传输全程加密,按任务挑协议就行。
常见问题
Q:同一个节点,白天快晚上卡,是节点坏了吗?
大概率不是坏了,是用的人多了。共享出口在晚间高峰排队,表现出来就是时快时慢。可以避开高峰跑任务,或者换成独享类产品,别在共享线路上反复重试。
Q:不同地区的 IP 试了一轮还是慢,问题在哪?
重点看带宽和并发,而不是 IP 数量。IP 决定的是"从哪出去",带宽决定的是"同时能干多少活"。先用实测吞吐算一下自己的并发需求有没有超过峰值,再决定要不要调规格。
Q:协议真的会影响速度吗,差别有多大?
会。SOCKS5 的握手开销最小,短连接任务优势最明显;IKEv2 在长时间连接上更稳,重连也快。同一个节点换个协议,跑量大的任务时总耗时差两三成是常见的事,值得花十分钟对比一次。
Q:本地要调的东西多吗,普通电脑能操作吗?
不多,也不用装什么专业工具。把无线换成有线、关掉后台同步、调一下 DNS 和 MTU、代码里打开连接复用并设好超时,这几步基本覆盖了大部分本地问题。