长期连接业务,跟"跑一次就换IP"完全是两码事
先说个常见场景。有个做电商比价的朋友,白天跑短任务一切正常——发请求、拿数据、断开,一条IP用几秒钟就丢掉。后来他们想把接口监控改成常驻模式,一个会话要挂上七八个小时不断开,问题立刻冒出来:跑二十分钟掉一次,半夜还会整段超时,日志里全是"Connection reset"。
短任务追求的是"快换",长连接追求的是"别断"。这两件事对代理IP的要求几乎相反。高匿名稳定代理ip之所以在长期连接业务里被反复提起,就是因为它同时盯住了两个点:一是别让目标站看出你是代理流量,二是别在第八个小时的时候突然没了。
下面按我自己的操作顺序来:怎么挑、怎么配、怎么盯。中间会贴几段可直接改参数就用的代码。
挑之前先想清楚:你的业务到底"长"到什么程度
不是所有挂着不放的连接都叫长连接。实际干活的时候我会分成三档:
分钟级——一次任务几分钟,比如抓一批商品页、查几十个关键词的搜索排名。这种用动态IP就行,断了重来成本低。
小时级——客服后台常驻、自媒体多账号后台登录状态保持、持续的接口监控。这种最怕中途换IP,因为一换就要重新登录、重新过验证。
天级甚至更久——服务器探活、长期的数据订阅通道。这种必须上固定IP,容不得地址变动。
把这三档分清楚,后面的选型就不会乱花钱。小时级和天级的业务,才真正需要"高匿 + 稳定"这两个属性同时在线。
判断一个代理能不能扛住长连接,我看三个点
市面上"高匿"两个字写得满天飞,实际表现差得远。我一般不看宣传页,直接看三样东西。
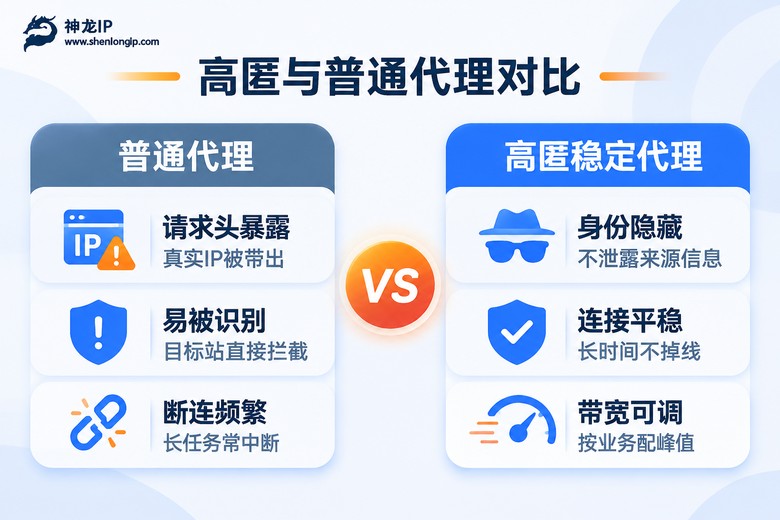
第一,请求头干不干净。透明代理会把你的真实来源直接写进请求头,目标站一眼看穿;普通匿名代理虽然藏了来源,但会留下"我是代理"的痕迹,比如莫名其妙的 Via、X-Forwarded-For 字段。高匿的要求是这些痕迹一点都不留,从外表看就是一台普通终端在访问。测试办法很简单,找个能回显请求头的接口打一下,把返回的 header 逐个过一遍。
第二,连接会不会被中途掐掉。这一项跟机房质量强相关。共享型、转手多次的线路,白天还行,一到晚高峰就开始丢包。长连接业务最怕这个,因为你没法像短任务那样失败了立刻重来——重来意味着状态全丢。
第三,时效和带宽对不对得上。很多长连接业务是低速持续型的,每秒几百KB就够,但不能忽快忽慢。带宽给得太小,几十个并发就把队列堵死;给得太大又浪费。这个要按业务的并发数去算,不是越大越好。
| 对比项 | 透明代理 | 普通匿名代理 | 高匿名稳定代理 |
|---|---|---|---|
| 请求头是否暴露真实来源 | 直接暴露 | 部分隐藏 | 完全不带 |
| 是否留下代理痕迹 | 明显 | 可能残留字段 | 无痕迹 |
| 长时间连接表现 | 易中断 | 波动较大 | 相对平稳 |
| 适合的业务 | 不建议使用 | 短任务、低频请求 | 小时级、天级常驻连接 |
配置环节:超时、心跳、重试,三件事定了就少一半故障
很多人拿到代理地址就直接塞进代码里跑,出问题再回头调,代价很大。我习惯在开跑之前先把三个参数写死在配置文件里,后面所有模块统一读。
# 长连接会话的基础参数(按业务实际调整)
CONNECT_TIMEOUT = 5      # 建连超时,别设太长,5秒足够
READ_TIMEOUT    = 30     # 读取超时,长连接业务可以给到30秒以上
HEARTBEAT_EVERY = 60     # 60秒打一次心跳,确认通道还活着
MAX_RETRY_SAME_IP = 2    # 同一条IP最多重试2次
SWITCH_ON_FAIL    = 0.3  # 失败率超过30%就换地区的IP
建连超时和读取超时要分开设,这是最容易踩的坑。合并成一个数字,结果是建连慢的时候你以为对方挂了,其实是握手还没完;读取慢的时候你又等不到数据就超时退出。
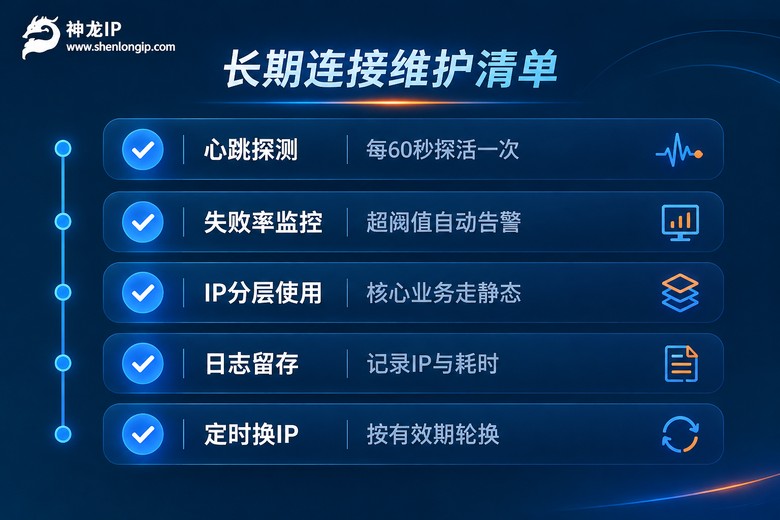
心跳是长连接的命脉。我的做法是每60秒发一个极轻量的请求——哪怕只是请求一个小的健康检查接口,拿到200就算活。连续两次失败,就判定这条通道死了,走换IP流程。
import requests
from requests.adapters import HTTPAdapter

s = requests.Session()
s.proxies = {
    "http":  "http://用户名:密码@代理地址:端口",
    "https": "http://用户名:密码@代理地址:端口",
}

# 连接池开大一点,避免长连接被频繁回收
adapter = HTTPAdapter(pool_connections=20, pool_maxsize=20, max_retries=0)
s.mount("https://", adapter)

r = s.get("https://目标地址/api/ping", timeout=(CONNECT_TIMEOUT, READ_TIMEOUT))
print(r.status_code, r.elapsed.total_seconds())
注意 max_retries=0 这一行别省。库自带的重试是不区分 IP 的,它会在同一条死掉的通道上反复撞,撞完三次才报错,白白浪费几十秒。重试逻辑自己写,才能做到"同一条IP重试两次,还不行就换地区的IP"。
还有一点:如果业务是 SOCKS5 走长连接,注意把 DNS 解析也放在代理侧,别让本地先解析一遍,否则请求头干净了,解析记录这边还是会漏。
维护环节:把"掉线"从玄学变成可查的数据
配置好只是开始。真正让长连接业务稳定的,是每天那几分钟的维护动作。我一般盯四样东西。
一是每条IP的存活曲线。给每条IP打个标签,记录它什么时候上线、跑了几小时、什么时候失效。跑上一周你就能看出规律:有些IP天生适合长挂,有些撑两小时就开始抖。把稳的IP单独拉一个池子,给核心业务用。
二是失败率阈值告警。失败率超过30%基本可以确定是线路问题,不是代码问题。这时候别急着改代码,先换一批IP验证。
三是心跳日志。只记录成功失败不够,要记耗时。某条IP的响应从80毫秒慢慢爬到800毫秒,说明它快不行了,提前换掉比分分钟掉线后再补救划算得多。
四是轮换节奏。不是所有业务都需要主动换IP。固定IP的业务只要能连就别动;用动态IP做长连接的,按服务商给的有效期提前换,别等到过期那一刻才手忙脚乱。
| 现象 | 大概率原因 | 先查什么 |
|---|---|---|
| 建连阶段就超时 | IP不可用或端口不通 | 换一条IP复测,确认不是本地出口问题 |
| 跑一段时间后报 Connection reset | 线路抖动或被对端主动断开 | 心跳耗时曲线是否在爬升 |
| 请求头被目标站识别 | 代理匿名度不达标 | 回显接口返回的 header 字段 |
| 偶尔返回登录失效 | IP在中途变了 | 核对当前出口IP与开始时是否一致 |
服务商怎么选:长期连接更看重机房和时效
短任务可以闭眼买便宜的,长连接不行。你买的其实不是"一条IP",是这条IP背后那台机器会不会在半夜被人挤爆。所以我一般优先看有没有自营机房、线路是否稳定。
按这个标准,神龙IP算是比较对口的选择。它家有自营机房,覆盖 200+ 城市可以做精准定位,1000万+ 纯净IP资源,响应能压到 30ms 这个量级,带宽 6-15M 可以按业务定制——长连接业务并发一多,这个可调的带宽就很关键,不用为了峰值去多买一档。协议上支持 IKEv2、PPTP、L2TP、SSTP、SOCKS5,传输全程加密,对接现有代码基本不用大改。
套餐上,我给长期连接业务一般推两种组合。核心的、不能断的通道走静态高级:长期固定IP,运营商合作资源,6Mbps 峰值,地址不变,登录状态和会话都能一直保持。外围的、可以随时替换的任务走动态独享:10Mbps 峰值,2-360 小时时效,独享线路不会跟别人抢带宽,跑完一段就换下一批。两者分开用,成本可控,稳定性也有保障。
常见问题
Q:高匿名到底怎么自测?有没有简单办法?
找一个能回显请求头的接口,通过代理打过去,把返回的 header 一条条看。如果里面出现了你的真实来源、或者多了 Via、X-Forwarded-For 这类字段,那就不算高匿。另外再看返回里有没有明显的代理特征标记,两项都干净,基本可以放心用。
Q:长连接一般多久换一次IP比较合适?
看业务性质。会话状态很重的(比如后台登录),能不换就不换,用固定IP跑到期再说;纯监控、纯数据流的,可以按服务商给的有效期提前一轮更换,比如 24 小时的IP在第 20 小时就替换掉,留出缓冲。硬卡着过期时间换,十次有八次会撞上正在传输的包。
Q:为什么白天一切正常,一到晚上就开始超时?
大概率是共享带宽被挤占。晚高峰时同一条线路上跑的人多,你的长连接就会被挤得响应变慢,最后触发读取超时。解决办法一是换独享型线路,二是把心跳间隔缩短,早点发现问题早点切换,别等业务真的断了才反应过来。
Q:静态IP和动态IP,长期连接业务该怎么选?
一句话:断不起的走静态,换得起、需要多地覆盖的走动态。像服务器探活、客服后台常驻这类,地址一变动就要重新认证,静态更省心;像分地区的排名监测、数据采集与IP轮换,动态独享更灵活。两种一起用,分层管理,是最常见的做法。