电商页面为什么一采就被拦?先看请求出口
做过商品页取数的人都遇到过这种场面:脚本刚跑两分钟,返回的就不是HTML,而是一段验证页,或者干脆403。代码没改、链接没变,问题往往不在解析逻辑,而在"请求是从哪里出去的"。
同一个出口地址在短时间内连续开几十个商品详情页,对方服务器看到的就是一条直线上升的访问曲线,拦你几乎不需要理由。更麻烦的是电商平台本身就存在地域差异——同一件商品,不同城市显示的价格、库存、甚至是否展示优惠券都不一样。你要做各地搜索排名测试、要核对区域价格,光靠本地一条宽带是做不到的。
这也是为什么数据采集与IP轮换几乎是绑在一起说的:让每次请求从不同城市、不同出口发出去,请求特征被分散,拿到的数据也更接近真实用户看到的样子。神龙IP支持200+城市精准定位,做区域价格核对时可以指定到具体城市去取,这一点比"随机出口"实用得多。
配置顺序别搞反:先通一条,再谈并发
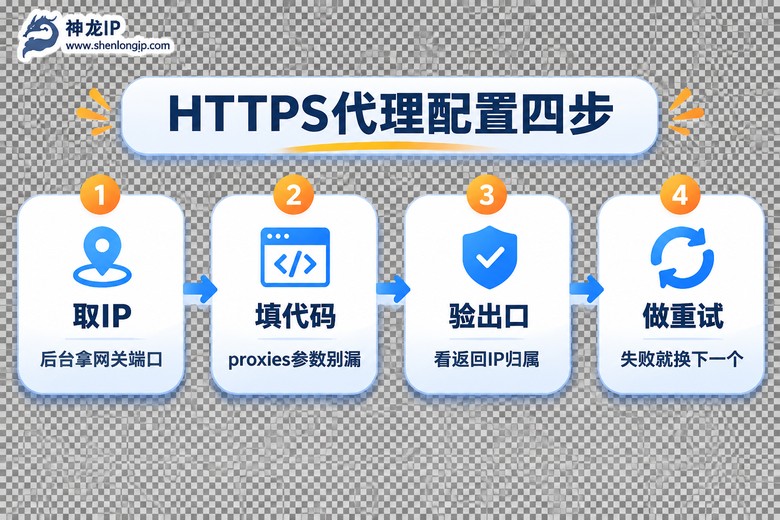
新手最容易犯的错,是直接在一堆并发任务里塞代理参数,跑挂了根本不知道是代理问题还是代码问题。正确的顺序很朴素:一条链路跑通,再往上加量。
第一步,在后台拿到三样东西——网关地址、端口、账号密码(或白名单授权方式)。第二步,用最简单的方式验证:一条命令,看能不能拿到目标页面的内容。第三步,才把它们写进代码。
这里有个细节值得说清楚:HTTPS请求和HTTP请求走的不是同一条路。访问 https 开头的页面时,客户端会先向代理发起 CONNECT 隧道请求,隧道建立之后数据才在加密通道里流动。所以你的代理必须支持隧道转发,否则就会出现"http页面能开、https页面一直超时"的怪现象。神龙IP 支持 SOCKS5、L2TP、SSTP 等协议,数据传输全程加密,日常写采集脚本用 HTTP(S) 或 SOCKS5 都能对上。
代码里怎么填:curl、requests、环境变量三种写法
先用 curl 摸一遍,这是最快的排查手段,返回码一眼就能看出是鉴权问题还是网络问题:
curl -x http://你的账号:你的密码@代理网关地址:端口 \
  -H "User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64)" \
  --max-time 15 \
  -o page.html \
  "目标商品页地址"
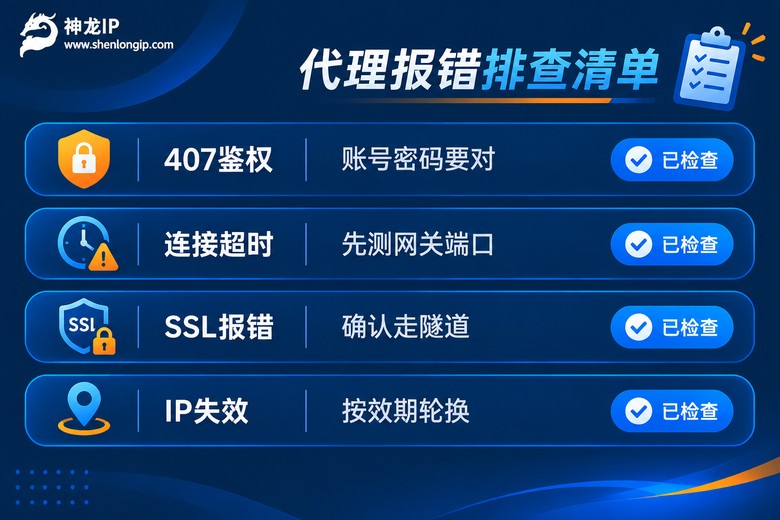
返回 200 并且 page.html 有几万字节,说明链路是通的;返回 407 是账号密码不对(密码里如果有 @ 或 # 这类符号,记得先做 URL 编码);返回 502、504 多半是网关或目标站点那边的问题。curl 通了,再进 Python。
Python 里最常用的是 requests,注意 http 和 https 两个键都要写。很多人只写 https,结果脚本里引用的图片、接口地址是 http 的,请求就直连出去了,白白暴露本机出口:
import requests

user = "你的账号"
pwd  = "你的密码"
gateway = "代理网关地址:端口"

proxy = f"http://{user}:{pwd}@{gateway}"
proxies = {"http": proxy, "https": proxy}

headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"}

resp = requests.get("目标商品页地址", proxies=proxies,
                    headers=headers, timeout=10)
print(resp.status_code, len(resp.text))
如果一次要连着取十几个页面,别每次都新建连接,用 Session 复用能省不少握手时间。神龙IP 的实测响应在30ms量级,配合同一个出口做连续访问,稳定性比每次重新建立隧道要好:
session = requests.Session()
session.proxies.update(proxies)
session.headers.update(headers)

for url in 页面列表:
    r = session.get(url, timeout=10)
还有一种零代码的写法:把代理写进环境变量,让本地工具自己走代理。适合临时调试,跑完记得清掉,不然会影响其他程序。
# Linux / macOS
export HTTPS_PROXY="http://账号:密码@代理网关地址:端口"
export HTTP_PROXY="http://账号:密码@代理网关地址:端口"
采集节奏与IP轮换:别让同一个出口打十几个页面
链路通了只是开始,真正决定成败的是节奏。我的习惯是:一个出口连续取 5 到 10 个页面就换一个,页面之间的间隔控制在 2 到 5 秒,并且把失败重试做成"换出口再试",而不是原地重试三次。原地重试,等于告诉对方"我就是要不停敲你这扇门"。
import random, time, requests

IP_POOL = ["IP1:端口", "IP2:端口", "IP3:端口"]   # 从后台拉取的可用出口
UA = "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"

def fetch(url, tries=3):
    for i in range(tries):
        node = random.choice(IP_POOL)
        proxies = {"http": f"http://{node}", "https": f"http://{node}"}
        try:
            r = requests.get(url, proxies=proxies, headers={"User-Agent": UA},
                             timeout=8)
            if r.status_code == 200:
                return r.text
        except requests.RequestException:
            pass
        time.sleep(1 + i)     # 退避一下,再换个出口
    return None
另外两个小坑。一是 SSL 报错:如果出现 SSLError,先确认代理支持 CONNECT 隧道,而不是急着加 verify=False——后者能让脚本跑起来,但你拿到的数据可就不敢保证了。二是 时效:动态IP有存活周期,脚本跑通一次不代表能跑一整天,出口列表要按效期补充。动态高级套餐的IP时效可选 2-360 小时,日更200万+,做持续几天的价格监控时,后台的可选范围会宽裕很多。
参数怎么挑:三种套餐对着活儿选
选套餐别只看价格,先看你的任务是什么形状。下面这张表可以对着自己的场景比一比:
| 套餐 | 峰值带宽 | IP时效 | 特点 | 适合的活儿 |
|---|---|---|---|---|
| 动态高级 | 6Mbps | 2-360小时 | 日更200万+,城市可选 | 多地区价格核对、短周期商品页取数 |
| 动态独享 | 10Mbps | 2-360小时 | 独享出口,不与他人共用 | 详情页图片多、单页体积大的采集任务 |
| 静态高级 | 6Mbps | 长期固定 | 运营商合作资源,出口稳定 | 需要长期保持同一出口的后台接口对接 |
三个套餐里,动态高级是大多数电商取数场景的起点:城市能选,时效范围宽,日更量大,够用且不浪费。如果你的目标页图片、脚本特别多,单页体积上到几MB,动态独享的 10Mbps 峰值会明显省时间——采集慢很多时候不是代码慢,是带宽卡住了。至于静态高级,它解决的是另一类问题:某些接口要求你在一个较长周期内保持同一个出口,那就别用动态的。
带宽这块,神龙IP 是 6-15M 可定制的,量上来了可以往上加,不用换服务商。机房是自营的,这一点在排查问题时很实际:链路是哪一段慢、出口是不是被目标站限速,问客服能问到具体环节,而不是一句"我们这边正常的"。
常见问题
Q:代码跑起来一直报 407,账号密码明明是对的?
A:九成是密码里的特殊字符在作怪。密码里带 @、#、: 这类符号时,拼进代理地址会被解析成别的东西,先用 URL 编码处理一下再拼。另外确认一下授权方式是账号密码还是白名单——如果是白名单,就要把当前机器的公网出口加进去,否则怎么填都过不去。
Q:proxies 里只写 https 可以吗?
A:不建议。页面本身是 https,但页面里的接口、图片资源可能是 http,只写 https 的话这些请求会走本机直连,出口就暴露了。两个键都填同一份代理,最省心。用 SOCKS5 的话,地址前缀改成 socks5:// 即可,注意要带上 socks5h:// 才能让域名在代理侧解析。
Q:配置都对了,跑到一半还是开始返403?
A:先分清是被目标站拦了还是出口不行。判断方法很简单:同一个页面,换一个城市的出口再取一次,能通就是出口的问题,还403就是请求特征的问题——常见的是请求头太"干净"(缺 UA、缺 Referer)、访问间隔太短、或者一个出口连续取了太多页面。把间隔拉到 3-5 秒、一个出口只取 5-10 页,多数情况下就缓过来了。
Q:动态高级和动态独享,我到底该选哪个?
A:看单页体积和任务时长。取的是纯HTML、页面结构简单,动态高级足够;要连图片、样式一起拿,或者单页上到几MB,动态独享的 10Mbps 更划算——同样的页面数,耗时可能差一倍。两个都支持 2-360 小时时效,可以先拿小任务测一轮,看实际耗时再决定长期用哪个。