本地跑得好好的爬虫,一放到服务器上挂机,半小时后日志里全是TimeoutError——这个场面,写Scrapy的人基本都遇到过。原因不复杂:你用同一个IP每秒发十几个请求,对面服务器不限制你限制谁。解决办法也直白,给每个请求挂上代理。但Scrapy没有一个"填个地址就能用"的代理配置项,它把这件事交给了下载中间件。这篇文章就把中间件怎么写、失败了怎么重试、坏IP怎么踢出去,一次给你理顺。
先弄明白:代理在Scrapy里挂在哪
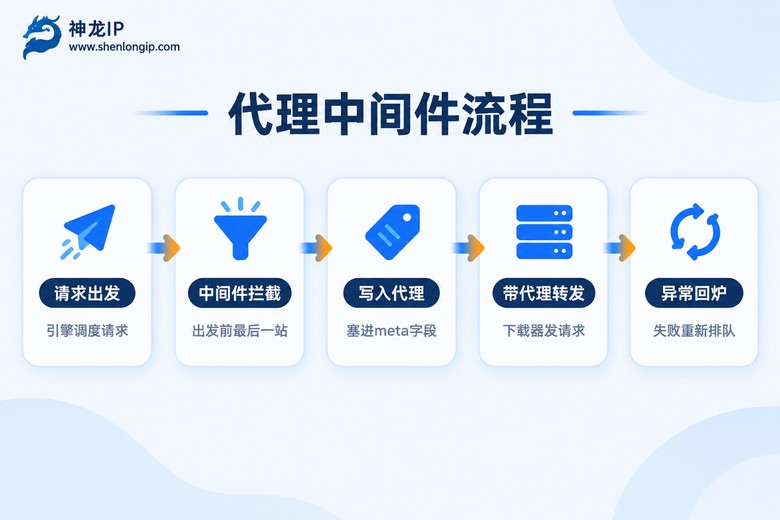
一个请求从出生到拿到响应,路径是这样的:引擎从调度器取出请求,依次穿过一层层下载中间件,最后交给下载器真正发出去。Scrapy其实内置了一个HttpProxyMiddleware,它只干一件事:看request.meta里有没有proxy字段,有就挂上。所以我们要写的"代理中间件",本质就是在请求出发前,把这个字段塞进去。
最简版本就一行:
def process_request(self, request, spider):
request.meta['proxy'] = 'http://账号:密码@代理地址:端口'注意格式:账号密码直接写进URL里,用@符号隔开。带认证的代理这样写,Scrapy会自动处理验证。目标网站是https也没关系,这里的http://指的是代理服务器自身的入口协议,不是目标站的协议。
手写一个随机代理中间件
单个IP撑不了多久,实际项目里都是维护一个代理池,每次请求随机抽一个。完整写法如下:
# middlewares.py
import random

class RandomProxyMiddleware:

    def __init__(self, proxy_list):
        self.proxy_list = proxy_list

    @classmethod
    def from_crawler(cls, crawler):
        # 从settings里读代理列表,方便统一管理
        return cls(crawler.settings.getlist('PROXY_LIST'))

    def process_request(self, request, spider):
        request.meta['proxy'] = random.choice(self.proxy_list)
settings.py里注册:
PROXY_LIST = [
    'http://账号:密码@114.80.1.1:4200',
    'http://账号:密码@114.80.1.2:4200',
]

DOWNLOADER_MIDDLEWARES = {
    'myproject.middlewares.RandomProxyMiddleware': 560,
}那个560是优先级数字,值得多说一句。请求阶段,中间件按数字从小到大依次过;内置的HttpProxyMiddleware是750,所以只要你的数字小于750,代理就会先塞进去、后生效。而到了异常处理阶段,顺序反过来,从大到小过——560排在内置重试中间件(550)前面,等于把坏IP的处理主动权拿到了自己手里。这个数字是我踩过坑之后才改对的,很多人抄网上的543,结果异常全被内置重试截胡,自己写的逻辑一次都没跑到。
如果代理是从服务商的提取接口动态拉的,把列表换成实时获取就行:
def process_request(self, request, spider):
    if not self.proxy_list:
        # 从服务商后台的提取接口拉一页新IP
        text = requests.get(self.api_url, timeout=5).text
        self.proxy_list = [line.strip() for line in text.splitlines() if line.strip()]
    request.meta['proxy'] = random.choice(self.proxy_list)
失败重试:把坏IP踢出去,请求重新入队
这里有个容易混淆的点:Scrapy内置的RetryMiddleware只管HTTP状态码,比如500、502会自动重试。但代理坏了往往不是状态码问题,而是连接超时、连接被拒,这类异常走的是process_exception。所以重试逻辑要自己写:
import random
from twisted.internet.error import TimeoutError, ConnectionRefusedError

class SmartProxyMiddleware:

    MAX_RETRY = 3  # 同一个请求最多重发3次

    def __init__(self, proxy_list):
        self.proxy_list = list(proxy_list)

    @classmethod
    def from_crawler(cls, crawler):
        return cls(crawler.settings.getlist('PROXY_LIST'))

    def process_request(self, request, spider):
        request.meta['proxy'] = random.choice(self.proxy_list)

    def process_exception(self, request, exception, spider):
        # 只处理连接层面的异常,状态码问题交给内置重试
        if not isinstance(exception, (TimeoutError, ConnectionRefusedError)):
            return

        # 把这次用的坏IP踢出代理池(池子只剩一个时先留着)
        bad = request.meta.get('proxy')
        if bad in self.proxy_list and len(self.proxy_list) > 1:
            self.proxy_list.remove(bad)

        # 超过重试上限就放弃,避免死循环
        retry_times = request.meta.get('retry_times', 0)
        if retry_times >= self.MAX_RETRY:
            spider.logger.warning(f'重试{retry_times}次仍失败: {request.url}')
            return

        request.meta['retry_times'] = retry_times + 1
        request.dont_filter = True  # 不然会被去重器拦下
return request # 返回request,引擎重新调度,会再走一遍process_request换新IP三个细节划一下重点:第一,dont_filter = True必须加,重发的请求URL没变,不加会被去重器直接丢掉,你会在日志里看到重试"成功"了但数据就是没回来;第二,重试次数一定要有上限,不然代理池整体出问题时,一个请求能无限循环刷爆你的日志;第三,返回request之后不用手动换IP,因为重新调度会再过一遍process_request,自然抽到新的。
除了连接异常,还有一种情况:请求成功了,但返回的是403或412,说明这个IP已经被目标站盯上。这时在process_response里补一刀:
def process_response(self, request, response, spider):
    if response.status in (403, 412) and request.meta.get('retry_times', 0) < self.MAX_RETRY:
        request.meta['retry_times'] = request.meta.get('retry_times', 0) + 1
        new_request = request.copy()
        new_request.dont_filter = True
        return new_request  # 换个IP再试
    return response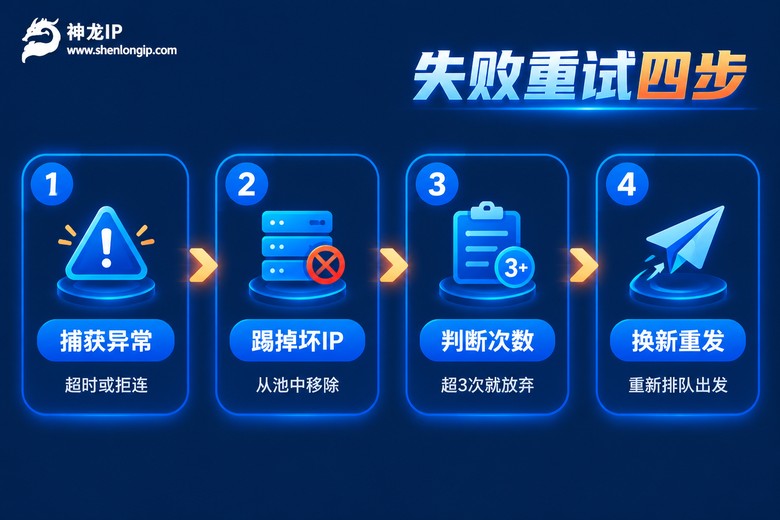
我踩过的四个坑,你直接绕开
坑一:SOCKS5代理直接填socks5://开头会报错。Scrapy对SOCKS的原生支持一般,最省事的做法是用服务商提供的HTTP入口。像神龙IP同时提供SOCKS5和HTTP等多种协议入口,Scrapy里选HTTP那个填就行,不用折腾。
坑二:并发一上来就拉满。CONCURRENT_REQUESTS默认16还好,有人改成100,再好的IP池也架不住这么烧。建议先小并发跑稳,再逐步往上调,边调边看超时率。
坑三:重试没有上限。前面说了,再强调一遍,MAX_RETRY这个闸门一定要有。
坑四:坏IP一直留在池子里反复被抽中。每次失败都白等一个超时周期,任务越跑越慢。踢出去的动作要放在异常处理里顺手做掉,别攒着统一清理。
至于代理资源本身,三条路线的差别很实际:
| 路线 | 稳定性 | 维护成本 | 适合场景 |
|---|---|---|---|
| 本机IP直跑 | 跑一阵就被限制 | 零 | 本地调试、量很小 |
| 免费代理列表 | 十个里能用一两个 | 高,得不停验活 | 练手学习 |
| 神龙IP动态高级 | 日更200万+IP,稳定 | 低,开箱即用 | 长期采集任务 |
代理资源怎么选,别在IP质量上省时间
免费代理不是不能用,是验活的功夫比写中间件还费劲。真要长期跑任务,我建议直接上付费动态代理,把时间花在解析和入库上。拿神龙IP的动态高级套餐举例:日更200万+IP,池子足够新鲜;时效2-360小时可调,这一点对Scrapy特别实用——几分钟能跑完的任务就设短时效,要挂一整夜的就设长时效,IP在有效期内反复用,到期自动换新的,中间件代码一行不用改。另外它有200+城市精准定位,需要指定城市出口时直接选就行,30ms的响应速度在同类里也算快的。
常见问题
Q: 中间件写了,但请求好像没走代理?
三步排查:确认settings里DOWNLOADER_MIDDLEWARES的路径写对了,格式是"项目名.文件名.类名";在process_request里打印request.meta,看proxy字段是否真的写进去了;确认没有其他中间件在后面覆盖了这个字段。优先级数字大于750也会出问题,改成560这种小于750的值。
Q: 重试会不会变成死循环?
不加次数限制就会。用request.meta里的retry_times计数,超过上限直接return放行,让引擎按失败处理。日志里把最终失败的URL记下来,方便事后补采。
Q: 代理需要账号密码,怎么填?
直接写进URL:http://用户名:密码@IP:端口。注意密码里如果有@、#这类特殊字符,要先做URL编码,不然会被解析错位。
Q: 一个IP能用多久,用完了怎么办?
看服务商的时效设置。神龙IP动态高级的时效是2-360小时可调,按任务时长选就行;到期后从提取接口再拉新IP补充进池子,重试逻辑会自动用上新的,不需要改代码。